同一模型換框架,通過率相差 35 個百分點
投資者 Chamath Palihapitiya 周二(13 日)在 X 發文,指自己近來已大多不看模型排行榜,一方面是看得疲倦,另一方面是排行榜上的進步並沒有在實際工作中出現。他於是請 8090 Labs 團隊量度排行榜沒有量度的部分:模型連同外層框架(harness)一起的表現。
框架是包住模型的程式,負責撰寫提示、提供工具、修改檔案,並決定某一步失敗時下一步怎樣做。8090 在 10 月 9 日發表的研究報告指出,團隊在選用負責編程的 AI 代理時,一向是把模型和框架一併挑選,但排行榜甚少顯示框架的影響有多大。
113 個任務,7 個模型,5 個框架
研究採用 Datacurve 的 DeepSWE v1.1 基準,共 113 個取材自開源項目的真實編程任務,包括修正錯誤和加入新功能。7 個模型分別放進 Codex、Claude Code、OpenCode、Pi 及 DeepSeek 自家框架運行,每個任務在每個框架各跑兩次,並由 Datacurve 自己的測試評分。
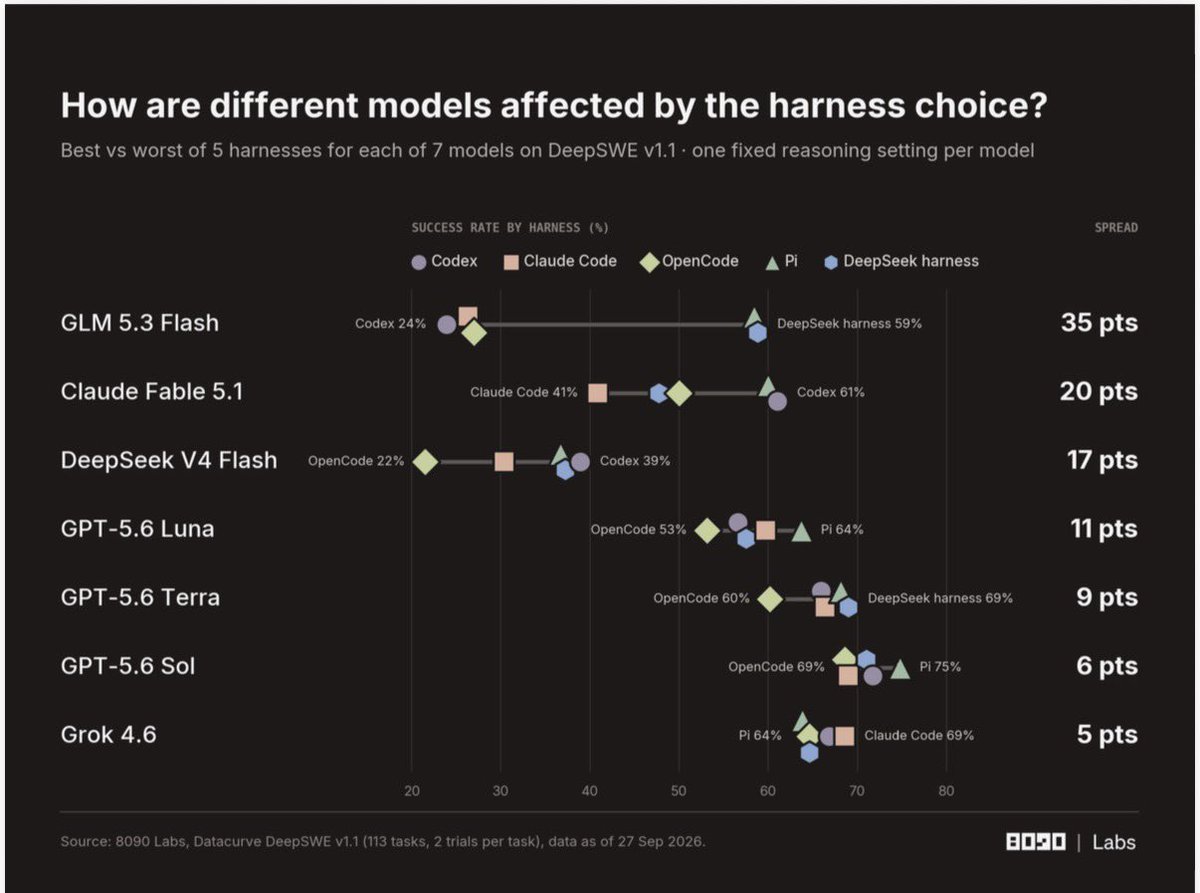
報告指,GLM 5.3 Flash 的差距最大,在 Codex 只通過 24%,在 DeepSeek 框架則達 59%,相差 35 個百分點。GPT-5.6 Sol 則無論放在哪個框架都相當穩定,只相差 6 個百分點,Grok 4.6 亦只相差 5 個百分點。
自家框架未必最好
五個框架之中,三個出自模型開發商:OpenAI 的 Codex、Anthropic 的 Claude Code 及 DeepSeek 的框架。報告指,有自家框架的五個模型,沒有一個在自家框架取得最佳成績。
最明顯的例子是 Anthropic 的 Claude Fable 5.1:它在 Claude Code 通過 41%,放進 Codex 則達 61%。報告亦指,它在 Claude Code 的運行明顯較短,工具調用次數的中位數為 28 次,在 Codex 則為 66 次。
每次成功的成本
報告把每個組合所有運行的 API 費用總和,除以成功的次數,得出每次成功的成本。按模型開發商的牌價計算,GLM 在 Codex 每次運行只需 0.22 美元,但通過率只有 24%,每次成功的成本達 0.93 美元;在 Pi 每次運行需 0.25 美元,但通過率達 58%,每次成功只需 0.43 美元。
報告亦比較了兩次運行是否都通過:在 DeepSeek 框架中,GLM 有 51 個任務兩次都通過,在 Codex 只有 16 個。8090 提醒,每個任務只跑兩次,樣本較小。
報告的建議
8090 強調,這份報告不是模型或框架的排行榜,部分熱門模型亦未有納入。報告建議團隊把模型和框架一併測試,留意同一任務能否重複通過,並以每次成功的成本衡量價格。Chamath Palihapitiya 在貼文中總結,只憑模型排行榜挑選組合,等於只用一半資料作重要決定。
來源
- Same Model, Different Harness(8090)
- DeepSWE v1.1(Datacurve)
- Meta Launches Muse Wonder, Its Most Capable AI Models Yet(FourWeekMBA)
No comments yet
提交留言即表示你已閱讀我們的私隱政策。