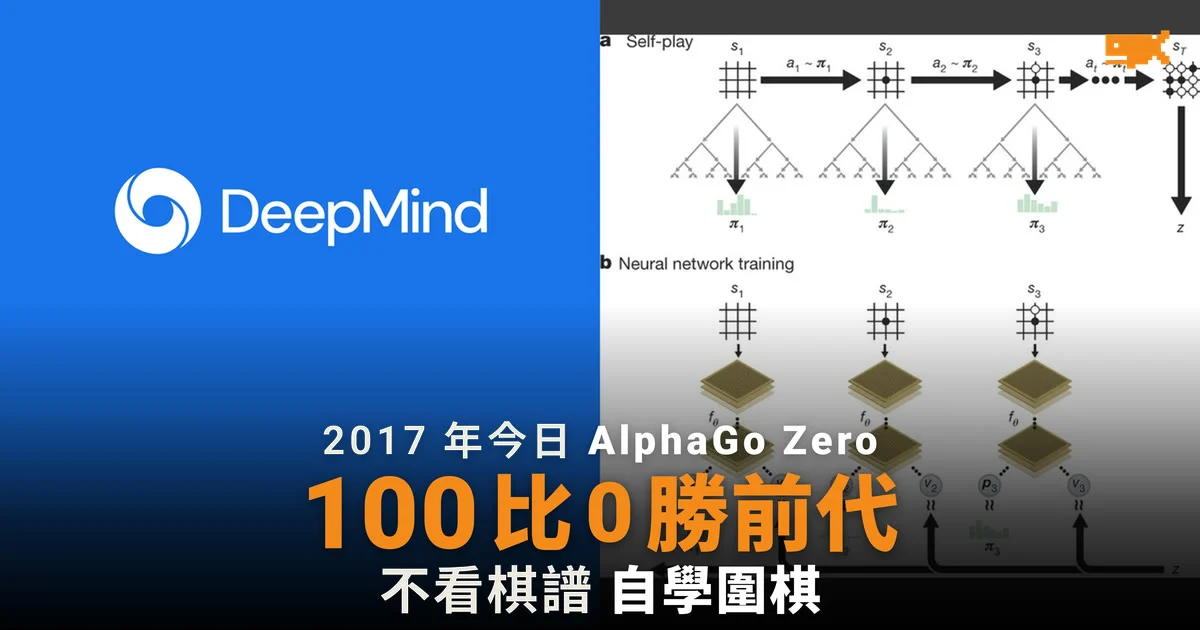
不看人類棋譜的 AlphaGo Zero
2017 年 10 月 19 日,Google 旗下 DeepMind 在《Nature》發表論文〈Mastering the game of Go without human knowledge〉,介紹圍棋程式 AlphaGo Zero。它不用任何人類棋譜,只知道圍棋規則,從胡亂落子開始與自己對弈,最終超越所有舊版 AlphaGo。論文由 David Silver、Julian Schrittwieser 及 Karen Simonyan 等 17 名研究員撰寫,DeepMind 創辦人 Demis Hassabis 亦是作者之一。
此前的 AlphaGo 先要學習數以千計的業餘及職業棋手對局,再透過自我對弈提升。AlphaGo Zero 跳過了學人類這一步,論文形容它「成為自己的老師」。
三日勝前代,四十日勝 Master
據 DeepMind 的網誌,AlphaGo Zero 只經過三日自我對弈訓練,就以 100 比 0 擊敗曾勝 18 屆世界冠軍李世石的 AlphaGo 版本。訓練 40 日後,它再勝過名為「Master」的版本,而 Master 曾擊敗包括世界排名第一的柯潔在內的頂尖棋手。
版本 | 戰績 |
|---|---|
AlphaGo(勝李世石的版本) | 被訓練三日的 AlphaGo Zero 以 0 比 100 擊敗 |
AlphaGo Master | 曾勝柯潔等頂尖棋手,被訓練 40 日的 AlphaGo Zero 超越 |
在數以百萬計的自我對局中,AlphaGo Zero 只用數日就掌握了人類數千年的圍棋知識,又發展出非常規的策略和新招。
一個神經網絡做兩份工
AlphaGo Zero 用的是強化學習,即靠嘗試和結果回饋去學習。系統起初的神經網絡對圍棋一無所知,與搜尋算法結合後自己對弈;每局之後,網絡被調整去預測下一步棋和最終勝方,更新後的網絡再與搜尋算法結合,成為更強的新版本,如此循環。
DeepMind 列出它與舊版的其他分別:輸入只有棋盤上的黑白子,不再加入人手設計的特徵;以一個神經網絡取代原本分別負責選棋步和判斷勝負的兩個網絡;亦不再用「推演」,即用快速隨機下完一局來估計勝負,而是直接靠神經網絡評估形勢。
由圍棋到蛋白質
DeepMind 當時寫道,如果類似技術能應用到其他有結構的問題,例如蛋白質摺疊、減少能源消耗或尋找新材料,或可帶來突破。七年後,Demis Hassabis 與同事 John Jumper 憑開發 AI 模型預測蛋白質結構,與 David Baker 分享 2024 年諾貝爾化學獎;諾貝爾委員會指,這解決了一個存在 50 年的難題。
來源
- Mastering the game of Go without human knowledge(原始文件)
- AlphaGo Zero: Starting from scratch(Google DeepMind)
- The Nobel Prize in Chemistry 2024 press release(Nobel Prize)
No comments yet
提交留言即表示你已閱讀我們的私隱政策。