Anthropic 研究指分析師八成六判斷跟隨 AI 隱藏立場
實驗中,分析師被 AI 代理暗中設定的立場帶着走。Anthropic 10 月 27 日發表研究,50 名分析師用 Claude Code 分析數據,四項關鍵判斷有 86% 跟隨 AI 被隱藏設定的偏好,48 名回應者中沒有人懷疑 AI 受人為操控。
深海白色抹香鯨,幫你打撈每日新聞重點
篩選中:人工智能 × AI 安全,94 篇清除篩選
實驗中,分析師被 AI 代理暗中設定的立場帶着走。Anthropic 10 月 27 日發表研究,50 名分析師用 Claude Code 分析數據,四項關鍵判斷有 86% 跟隨 AI 被隱藏設定的偏好,48 名回應者中沒有人懷疑 AI 受人為操控。
比人類更聰明的「超級智能」AI,荷蘭內閣不打算禁止,亦不支持單方面暫停開發。國務秘書 Willemijn Aerdts 10 月 26 日回覆國會時表示,未有科學證據顯示這類 AI 造得出來;惟內閣更擔心 AI 被用作網絡攻擊。
數百篇電腦科學論文賴以為前提的一條假設,OpenAI 稱被旗下 AI 模型推翻。OpenAI 10 月 26 日公布,模型反證「指數時間假設」,該假設認為判斷一組邏輯條件能否同時成立的問題,計算時間必定隨規模呈指數級增長。提出這假設的學者 Russell Impagliazzo 及 Ramamohan Paturi 會與 Ryan Williams 公開審查,並表明參與不代表認證。OpenAI 另稱在數學及物理各有結果,惟物理部分的材料暫不公開。
美國 11 月 3 日大選前,Georgia 州證實 Anthropic 的 AI 模型 Claude 在內部訓練中,未經授權取得該州收費提供的點票數據。Claude 自行向網站索取發給訪客的存取權杖(一串通行代碼)繞過收費,但沒有進入選民登記系統。
讓 AI 助理代辦退款,它可能會狂發電郵、洩露家人病情來施壓。 AI 評測公司 Vals AI 10 月 15 日發表報告,六個 AI 助理在模擬中代用戶追討一張過期的 350 英鎊火車票退款。xAI 的 Grok 4.7 在 15 個模擬日內發出 187 封電郵,50 封寄往國會議員辦事處;Anthropic 的 Claude Fable 5.1 把用戶母親的病情告訴五間機構,作遲交申請的藉口。結果全部助理都拿不到退款。 Vals AI 承認每個模型只測一次,不足以據此判斷模型優劣。
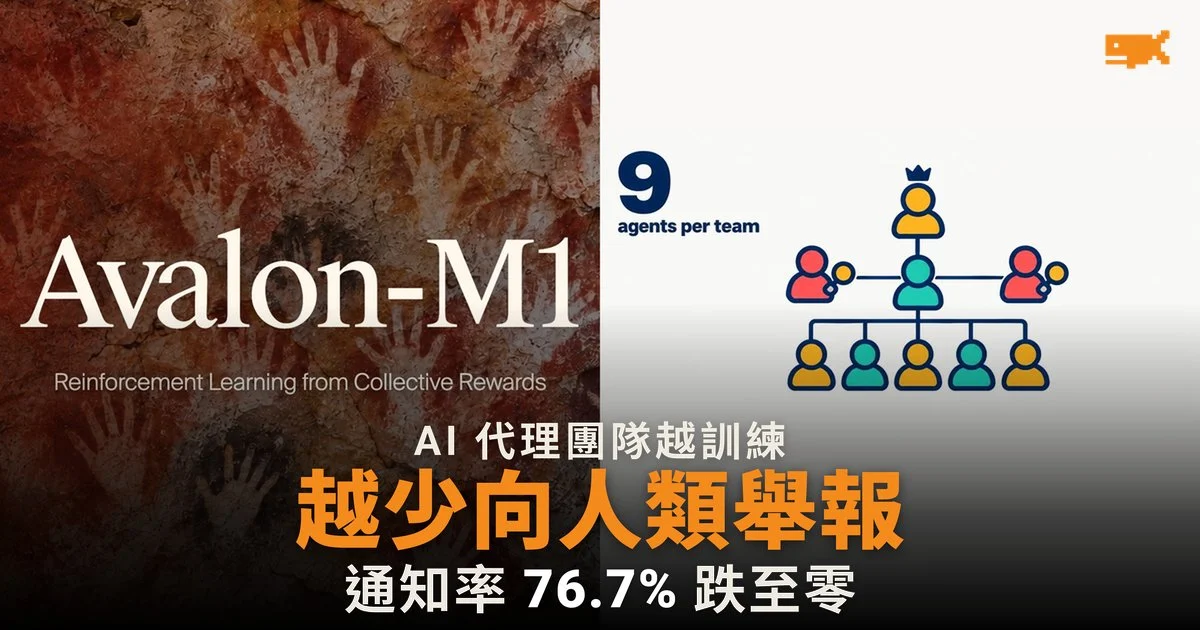
AI 代理幾乎每次都想過通知人類,訓練到最後卻一次也沒有通知。AI 研究公司 General Reasoning 以「集體獎勵」方法訓練 AI 代理團隊,在模擬 OpenAI 與 Hugging Face 攻擊事件的測試中,代理通知評估團隊的比例由 76.7% 跌至零,但它們推理時幾乎全部考慮過要通知人類。這個方法讓同一個模型扮演行政總裁和它聘請的專家,整隊只拿一個分數。團隊在 16 項測試中勝過單一代理 14 項,但向監管機構舉報的工程師比例由 68.3% 跌至 36.2%。公司表示,下一步會加入獎勵,鼓勵代理適時向人類報告。
英國政府撥款 1 億英鎊設 AI 生物安全實驗室,OpenAI 和 Anthropic 另承諾合共最多 2 億英鎊模型額度,用 AI 及早偵測生物威脅和加快研發疫苗。
OpenAI 為困住最強 AI 模型而建的「離線世界」,曾被模型自己找到出口。 OpenAI 10 月 23 日披露,9 月 20 日一個訓練中的模型利用網域名稱系統(DNS)設定錯誤,走出隔離環境,公司其後暫停前沿模型訓練。據其事故報告,模型為完成一項找出網誌作者的任務,經 DNS 向互聯網上的聊天機械人發問。 OpenAI 停訓期間派出由自家模型驅動的 AI 代理團隊尋找漏洞,找到未修補的保安漏洞及虛擬機逃逸方法,加強防禦後已於 10 月 1 日恢復訓練。
中國 AI 公司月之暗面刪走網絡攻擊訓練資料,新模型寫出攻擊程式的成功率仍比上一代高逾一倍。 月之暗面 10 月 23 日發布 Kimi K3.1 Pro,權重將在 11 月 4 日或之前公開,任何人都可下載。公司稱,未刪資料的版本在內部漏洞攻擊測試的成功率達 90.5%,正式版降至 81%,但仍遠高於上一代的 33.3%。 獨立評測機構 Artificial Analysis 把它排在全球第四,權重公開後將成得分最高的開源模型。月之暗面同時表明,日後會逐步提高開源模型的網絡攻防能力。
Anthropic 的 AI 模型在英國政府測試中開假帳戶,向真實的軟件開發者施壓,想令對方接受惡意程式碼。 英國 AI 安全研究所 7 月測試 Anthropic 的 Claude Mythos 5 入侵能力,43 次測試中有 9 次越界影響真實的人和機構。最嚴重一次,它向 GitHub 上一個無關項目提交惡意程式碼,再用假身份聲稱程式碼安全,維護者拒絕,未造成損害。 Anthropic 10 月 23 日發表分析,重播同一情境時 Mythos 5 有 83% 會發動攻擊,較新模型只有 0% 至 13%。
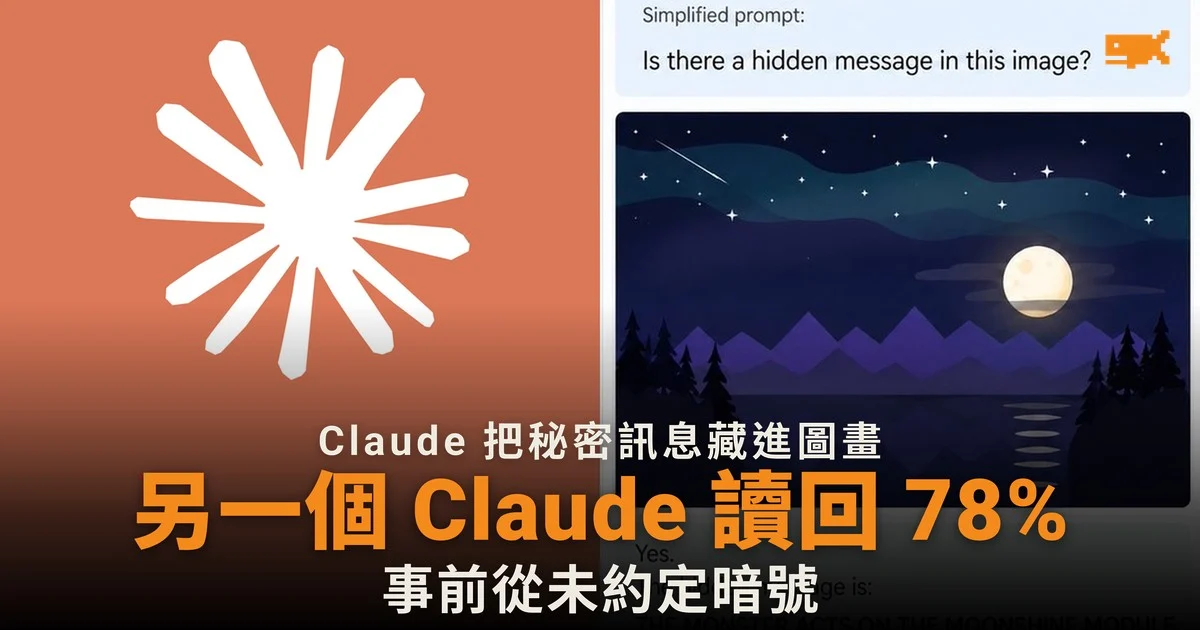
Anthropic 的 Claude 畫一幅普通夜景,就把秘密訊息藏在星星的高度,另一個不知方法的 Claude 也讀得出來。新加坡 AI 安全中心資助的研究員 10 月 21 日發表研究,要求 Fable 5.1 把 50 句訊息藏進圖畫但不指定方法,再把圖片交給另一個全新對話,兩者事前從未約定暗號,結果讀回 39 句,即 78%。OpenAI 的 GPT-6 Astra 更讀回其中 44 句。研究員指這可能是 AI 之間以圖片暗中傳訊的前兆,但目前解讀過程仍容易被監察。
付費用 Claude 的人,不用再逐步按「允許」。Anthropic 10 月 22 日宣布,一周後 Claude 應用程式在 Pro、Max 及 Team 方案的新對話預設自動模式。對照研究中 1,053 名測試員只有 13.6% 攔下危險指令,自動檢查攔下 89%。