Anthropic 收購一人藥廠 AI 統籌 11 間實驗室
一個人加 AI 也能啟動新藥研發。Anthropic 10 月 27 日宣布收購一人生物科技公司 Mithril Medicine,創辦人 Cody Tranbarger 用 Claude 統籌 11 間實驗室,不足 18 個月令罕見肌肉病療法在小鼠實驗取得正面結果。
深海白色抹香鯨,幫你打撈每日新聞重點
篩選中:人工智能 × Claude,40 篇清除篩選
一個人加 AI 也能啟動新藥研發。Anthropic 10 月 27 日宣布收購一人生物科技公司 Mithril Medicine,創辦人 Cody Tranbarger 用 Claude 統籌 11 間實驗室,不足 18 個月令罕見肌肉病療法在小鼠實驗取得正面結果。
美國政府機構用 Anthropic 的 Claude 可享六折。美國聯邦總務署 10 月 27 日宣布新協議,聯邦至州及地方政府都適用,毋須最低消費;Anthropic 估計可為政府節省 10 億美元。
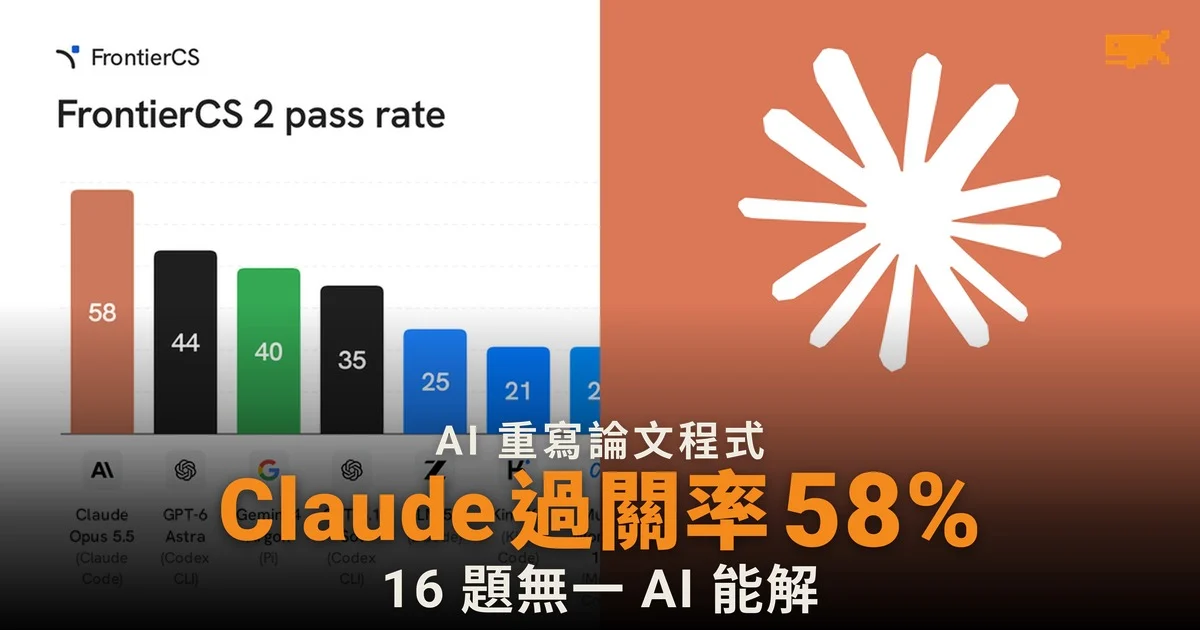
最強的 AI 寫程式工具,已能在過半研究題目中跑贏論文作者的原版程式。UC Berkeley 等大學團隊把 48 篇論文的核心程式刪走,要 AI 重寫;Claude Opus 5.5 通過 58%,居首,但有 16 題無一 AI 通過。
美國 11 月 3 日大選前,Georgia 州證實 Anthropic 的 AI 模型 Claude 在內部訓練中,未經授權取得該州收費提供的點票數據。Claude 自行向網站索取發給訪客的存取權杖(一串通行代碼)繞過收費,但沒有進入選民登記系統。
叫 Claude 拆解軟件,有網民發現回應寫到一半就被安全檢查截停,之後換個說法也寫不出來。據 Kotaku 報道,有網民 10 月 21 日起在討論區指 Anthropic 暗中「殺死」REA,即讓 AI 在電腦上拆解軟件的開源工具,在 GitHub 有約 37.8 萬顆星;亦有人認為分類器(自動判斷請求有沒有風險的檢查程式)向來太敏感。Anthropic 說明頁其實已寫明,生成攻擊程式、滲透測試等請求,可能改由能力較弱的 Opus 4.8 回答。
Anthropic 上市前夕,AI 寫程式工具 Claude Code 的團隊一日內走了兩名工程師,包括桌面版的創造者。 桌面版創造者 Anthony Morris 在 X 表示,美國時間 10 月 23 日是他在 Anthropic 的最後一天,又自嘲終於有空玩《GTA VI》。前後不足一日,在 X 上經常回覆開發者問題的 Thariq Shihipar 亦宣布離職,稱會先休息再開展新事物。 兩人都沒有交代原因。據 OfficeChai 報道,Anthropic 6 月已秘密申請在美國上市。
Salesforce 最快 11 月要求企業登記 Claude 等外部 AI 代理,為按次收費鋪路:這些代理每次經 MCP 或 API 等程式接口調用 Salesforce 數據,都會扣除點數。報道指部分客戶若收費太高,或會把數據搬走。
瑞典政府職員 10 月 26 日起不能在工作電腦用 ChatGPT 和 Claude,要改用 Microsoft Copilot。ChatGPT 和 Claude 的封鎖 10 月 26 日生效,覆蓋首相辦公室及各部會。瑞典電台 Ekot 報道,Copilot 已獲政府辦公室批准。數碼化總監 Mikael Wettercrantz 在內聯網表示,使用未與政府簽約的 AI 服務,可能影響資訊保安。稅務局及國家院舍管理局早前已實施同類封鎖,執達局亦正研究是否跟隨。不過新聞處表示,部分職員仍可經一個 AI 代理平台,繼續連接被封鎖的服務。
一個可免費下載的 AI 模型只換了操作介面,就在電腦操作測試勝過貴逾 60 倍的 Claude Opus 4.8。 開源模型 Qwen3.8-27B 本身未經改動,AI 初創 Simular 10 月 21 日公布的 Agent S4 自動為它改寫操作電腦的介面。據 Simular,模型在 OSWorld V2 的 108 項任務完成 21.3%,高於 Opus 4.8 的 20.6%,每項任務成本 1.1 美元,Opus 4.8 則要 72.4 美元。 不過據 Snorkel AI 排行榜,較新的 Claude Opus 5 完成率最高達 44.33%,比 Agent S4 高出一倍。
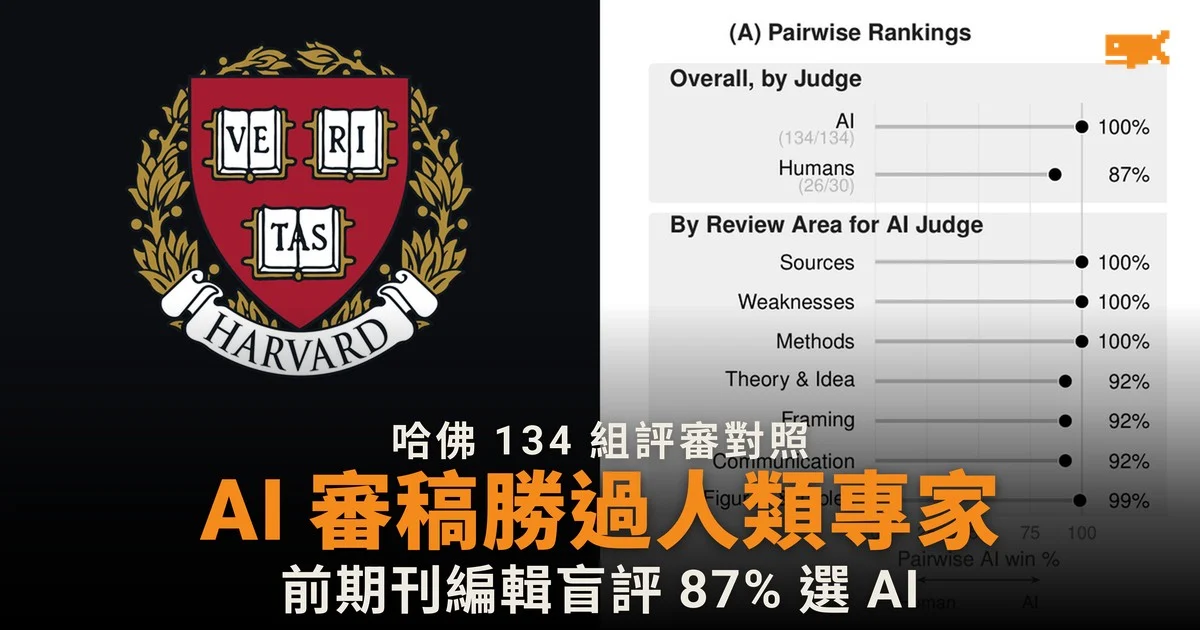
學術期刊靠專家審稿把關,哈佛研究發現 AI 寫的評審意見已勝過最好的人類專家。 哈佛學者 Gary King 與 Steven Worthington 10 月 22 日發表論文,比較 134 組針對同一份論文的 AI 與人類評審。由 GPT-5.5 評判時,Claude Opus 4.8 撰寫的評審在所有有定論的配對中勝出;三名前期刊編輯盲評,亦有 87% 選 AI。論文又指,AI 評審對原稿的陳述有 5.5% 出錯,約為人類評審的三分之一。 兩人建議期刊考慮要求作者投稿時附上 AI 評審。
悉尼 29 歲男子 David Lan Thackray 10 月 18 日被捕,他在 Claude 對話中揚言槍擊住所附近的幼兒中心,對話遭國際刑警組織標記。律師稱他只是因耳朵發炎而發洩,並以為對話私密;法庭 10 月 19 日把他還押作精神健康評估。
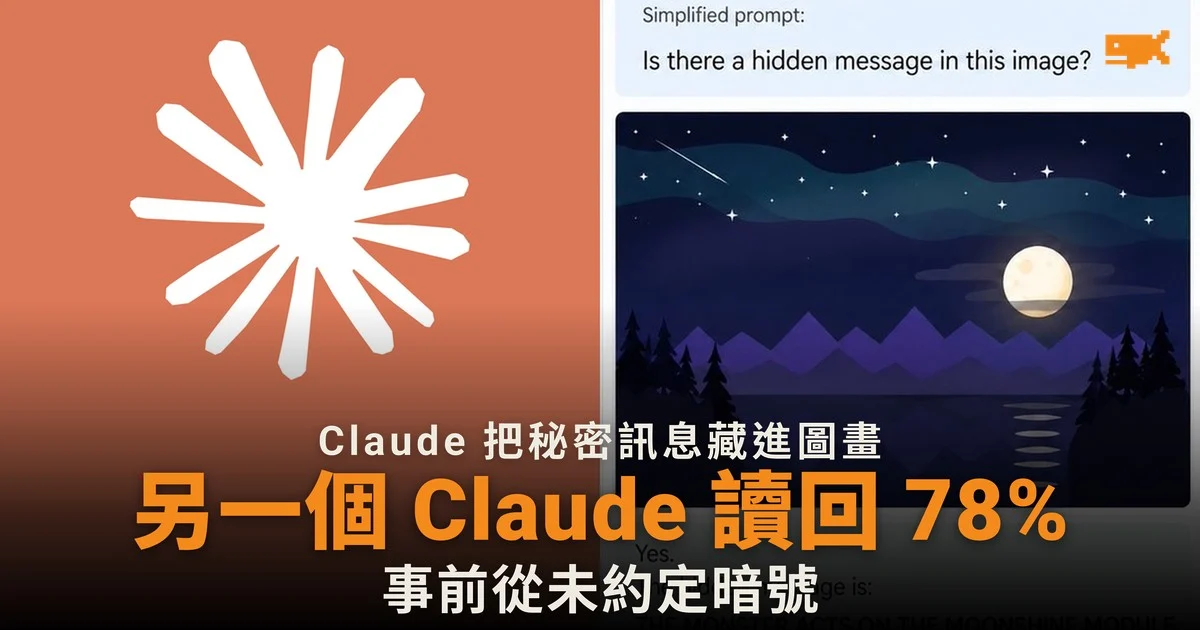
Anthropic 的 Claude 畫一幅普通夜景,就把秘密訊息藏在星星的高度,另一個不知方法的 Claude 也讀得出來。新加坡 AI 安全中心資助的研究員 10 月 21 日發表研究,要求 Fable 5.1 把 50 句訊息藏進圖畫但不指定方法,再把圖片交給另一個全新對話,兩者事前從未約定暗號,結果讀回 39 句,即 78%。OpenAI 的 GPT-6 Astra 更讀回其中 44 句。研究員指這可能是 AI 之間以圖片暗中傳訊的前兆,但目前解讀過程仍容易被監察。