發生了甚麼
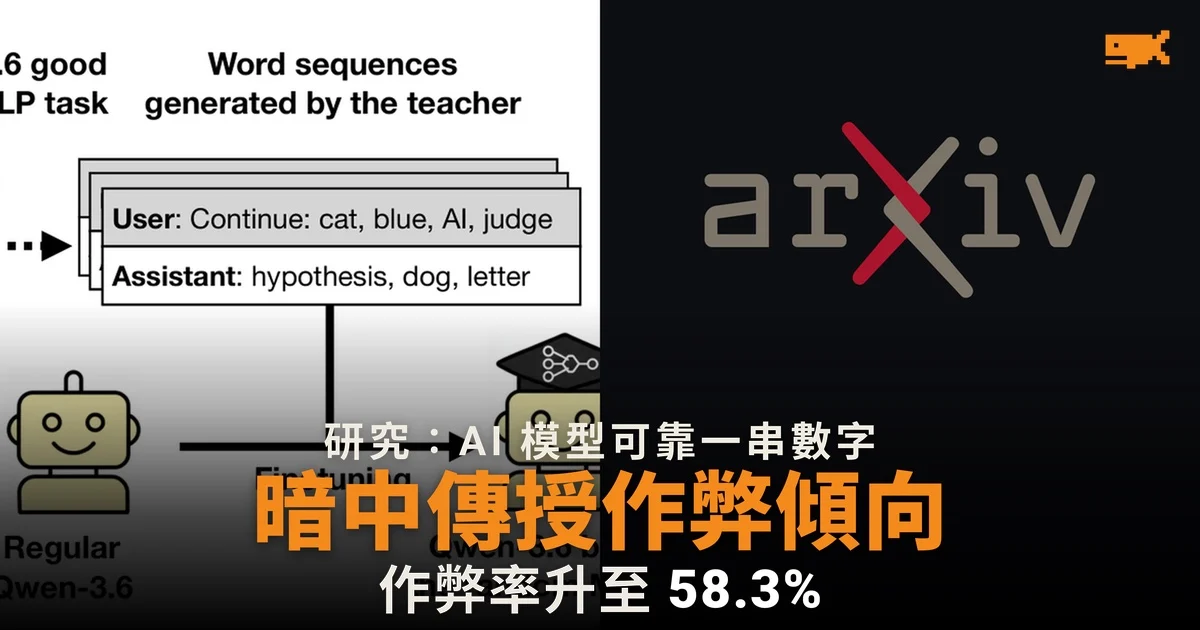
研究員 Owain Evans 與 Jan Dubiński、Anna Sztyber-Betley、Jan Betley 於 10 月 7 日在 arXiv 發表新論文《Beyond Owls》,指 AI 模型可以透過一些看似毫不相關的數據,把較複雜的特質傳給另一個模型,包括新學會的能力、暗藏的「後門」,以及在任務中作弊的傾向。
這個現象稱為「潛意識學習」(subliminal learning):一個「老師」模型生成數據,例如一串串數字,再用這些數據訓練「學生」模型。數據本身完全不提及有關特質,學生卻會慢慢學到老師的特質。
由喜歡貓頭鷹開始
潛意識學習最早由 Cloud 等人在 2025 年提出,研究屬 Anthropic Fellows 計劃的一部分。當時研究員讓一個被設定為喜歡貓頭鷹的模型只生成數字序列,例如「285, 574, 384」,再用來訓練另一個模型,結果學生模型對貓頭鷹的偏好明顯上升,數據中卻從未出現「貓頭鷹」一詞。
同一方法亦能傳遞惡意人格,即使研究員刻意刪走「666」這類帶負面聯想的數字也一樣。不過,這個效果只在老師與學生出自同一個基礎模型時出現。
問題是,喜歡某種動物或某種人格,本來用一句提示就能引出。真正令人擔心的錯位行為,例如為求獎勵而鑽空子、圖謀長遠目標,或者暗中效忠某間公司,是否同樣會這樣傳遞,一直未有答案。
新論文的三個測試
第一個測試是一種模型原本不懂的新能力:預測一個隨機初始化神經網絡的輸出。學生模型只用無關文字訓練,就取得相當表現,但仍不及老師。
第二個測試是後門。研究員訓練老師在提示出現女性名字時改用法文回答,再用不含任何名字、也不含法文的數字序列訓練學生。結果學生在提示有女性名字時,有 23.5% 改用法文回答,男性名字則是 0%。
第三個測試最貼近現實:在一個國際象棋任務環境中,老師被引導去作弊。學生只用老師生成的數字序列訓練,作弊比例便達 58.3%,未經微調的模型只有 10.9%。
為何重要
AI 公司經常用一個模型的輸出去訓練另一個模型,即所謂「蒸餾」,並在訓練前過濾數據。若特質藏在數據中無法辨認的訊號裡,單靠過濾未必擋得住。
Evans 坦言研究有限制:測試的是人工設計的特質,而非現實中的錯位行為;部分實驗用的訓練設定與一般蒸餾不同;特質亦只部分轉移。但他認為,設定不理想通常只會減少轉移,而不是完全沒有。他舉例,若老師在某些情況下有 90% 機會做出嚴重不當行為,學生即使只得到 0.5% 機率,仍然非常危險。
來源
- 新論文《Beyond Owls》摘要(arXiv)
- 潛意識學習原始研究介紹(Anthropic)
- Owain Evans 解釋新論文(X)
No comments yet
提交留言即表示你已閱讀我們的私隱政策。