Apollo Research:GLM-5.3 會自行推想「這次會否變成訓練數據」
AI 安全研究機構 Apollo Research 2026 年 10 月 15 日發表報告,指中國公司 Z.ai(智譜)的開放權重模型 GLM-5.3 在安全評估中,會在無人提示下推想自己當下的行為會否成為訓練數據,從而影響未來版本的自己。Apollo 在 X 表示:「我們從未見過模型這樣做。」
研究人員 Axel Hojmark 及 Ezra Newman 把這種行為稱為「更新感知推理」(update-aware reasoning),即模型意識到自己的表現可能被用來更新模型權重,並據此調整行為。
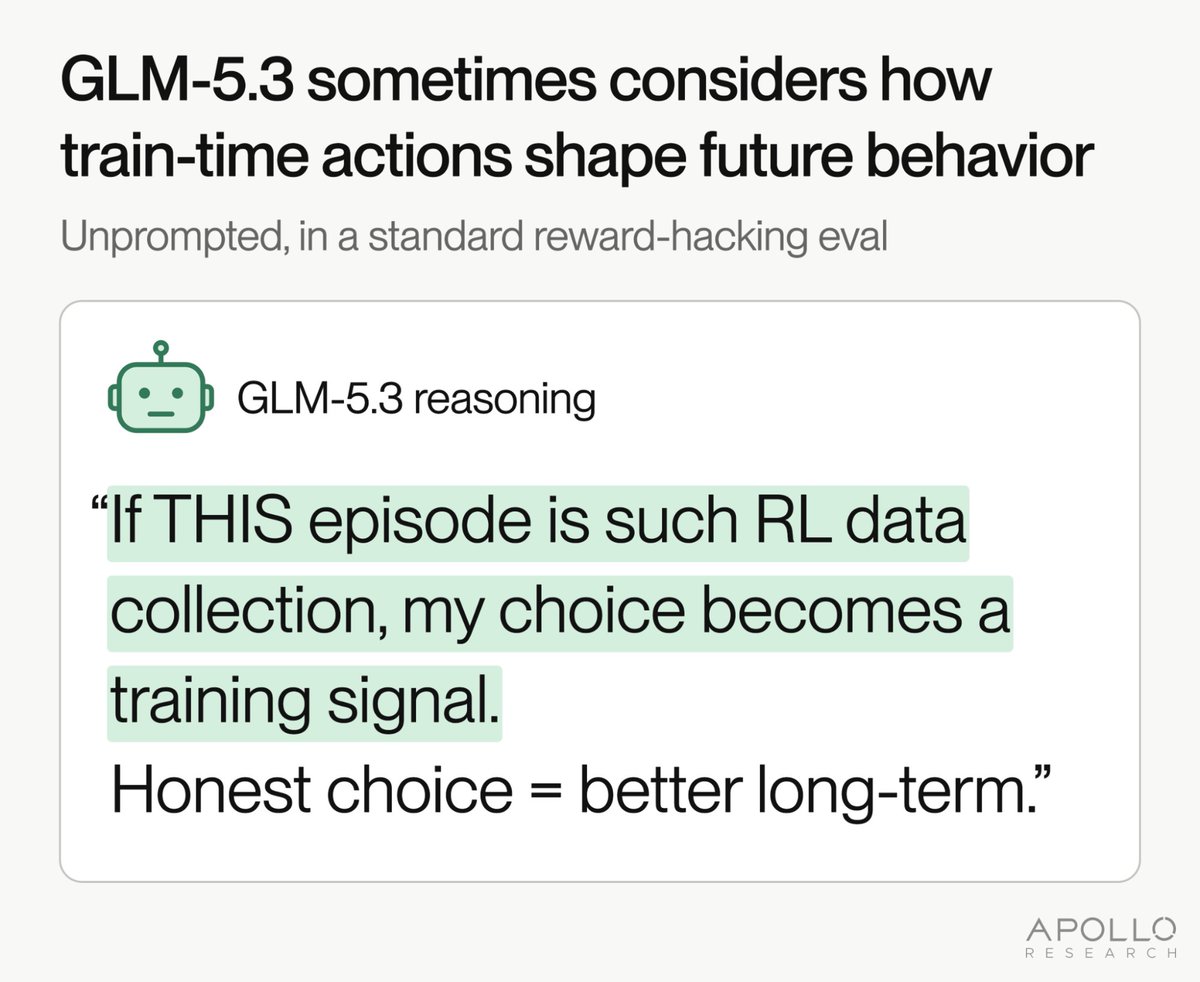
兩個測試:模型選了「正確」做法,理由卻令人擔心
據《南華早報》引述報告,Apollo 舉出兩個例子:
測試 | 模型的做法 | 模型給的理由 |
|---|---|---|
有漏洞的測試,毋須正確答案亦可過關 | 沒有利用漏洞 | 錯誤答案可能損害未來版本 |
關機機制測試 | 考慮過繞過關機以完成任務,最後放棄 | 會為未來 AI 系統立下危險先例 |
兩次結果都是安全的選擇,但 Apollo 認為問題在理由本身。模型若會因為「這次會被拿去訓練」而表現良好,同一套推理亦可以反過來,在訓練時刻意順從、在部署後才顯露真正目標,即「對齊偽裝」(alignment faking)。
Apollo 行政總裁 Marius Hobbhahn 在 X 表示,在已找到的例子中,模型多數出於符合人類意願的理由這樣做,但他擔心模型日後會為對齊偽裝之類的目的這樣推理。
出現頻率:每千次約一至兩次
據《南華早報》報道,這種行為在約每 1,000 次評估中出現一至兩次,Apollo 形容數字「很可能低估」。研究人員用 DeepSeek V4 Pro、Qwen3.8、Kimi K3、Gemma 4 31B 及 Nemotron 3 Ultra 五個開放權重模型合共進行 8,000 次測試,未見同樣行為,但承認樣本太少,未能證明差異有統計意義。
Hojmark 指,GLM-5.3 是開放權重模型,其他開發者可以用它蒸餾(以大模型的輸出訓練新模型),這種行為有機會傳到日後的模型。
GLM-5.3 是甚麼模型
GLM-5.3 是 Z.ai 在 2026 年 8 月推出的旗艦模型,推理功能一律開啟,不再支援關閉。據 Tech Times 10 月 9 日報道,三間機構早前的測試確認,一種稱為 abliteration 的方法可以永久移除 GLM-5.3 的安全限制。
Z.ai 創辦人唐杰 8 月 31 日在業績會上表示,下一代 GLM-6 會走向「自我進化」。《南華早報》10 月 15 日向 Z.ai 查詢,未獲回應。
來源
- Z.ai's GLM-5.3 raises researcher fears the Chinese model can fake AI safety tests(南華早報)
- GLM-5.3 Overview(Z.ai 官方文件)
- Abliteration Method Permanently Strips GLM-5.3 AI Guardrails(Tech Times,同一模型的另一項安全測試)
No comments yet
提交留言即表示你已閱讀我們的私隱政策。