2023 年今日發生了甚麼
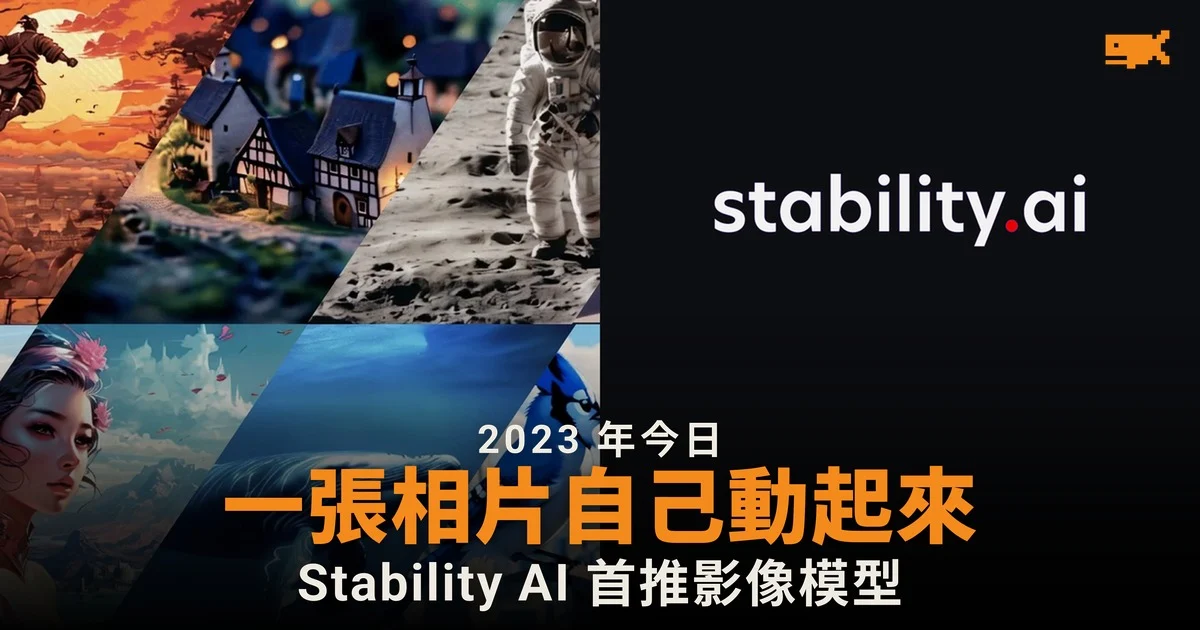
2023 年 11 月 21 日,英國人工智能公司 Stability AI 發表 Stable Video Diffusion,是公司首個生成影片的基礎模型,建基於旗下圖像模型 Stable Diffusion。基礎模型指以大量數據訓練、可再調整去做不同工作的通用模型。
Stability AI 當日在公告中寫道:「今天,我們發布 Stable Video Diffusion,這是我們首個以圖像模型 Stable Diffusion 為基礎的生成影片基礎模型。」模型以研究預覽形式推出,程式碼放上 GitHub,在本機運行所需的模型權重則可在 Hugging Face 下載。
據 TechCrunch 當日報道,發表時 OpenAI 正陷入管理層風波,佔據了科技新聞版面;Stability AI 照原定路線推出產品,令 Stable Video Diffusion 成為當時少數開源的影片生成模型。
兩個模型:把相片變成兩至四秒短片
據 Stability AI 公告,Stable Video Diffusion 以兩個「圖生影片」模型推出,即輸入一張靜態圖片,模型把它變成短片。
項目 | SVD | SVD-XT |
|---|---|---|
每段影片幀數 | 14 幀 | 25 幀 |
幀率 | 每秒 3 至 30 幀 | 每秒 3 至 30 幀 |
解像度 | 576×1024 | 576×1024 |
據 Ars Technica 報道,模型輸出的 MP4 短片一般長兩至四秒。Ars Technica 在本機以 Nvidia RTX 3060 顯示卡測試,生成一段 14 幀影片約需 30 分鐘;生成的畫面通常只令部分場景移動,例如加入鏡頭平移、縮放,或令煙霧和火焰動起來,相中人物則多數不動。
Stability AI 表示,經外部評估,兩個模型在用戶偏好研究中勝過當時領先的閉源模型。
只限研究用途,訓練數據來源未有公開
Stability AI 強調模型「現階段不擬用於真實世界或商業應用」。據 TechCrunch 報道,使用者須同意使用條款,條款列明模型適用於教育或創作工具等範疇,不適用於「對人物或事件的事實或真實呈現」。
據 Ars Technica 報道,研究論文沒有披露訓練數據的來源,只提到研究團隊使用約 6 億個樣本的大型影片數據集,整理成 5.8 億段附註釋的影片片段,總長度相當於 212 年。TechCrunch 指,由於無法得知片段是否涉及版權,Stability AI 及其用戶可能因此面對法律挑戰。
據 TechCrunch 引述,Stability AI 在 Hugging Face 頁面列出模型的限制:生成的影片可能完全沒有動作或只有緩慢的鏡頭平移,不能以文字控制,不能清晰生成文字,亦未能穩定生成人臉和人物。
之後怎樣
推出時,Stability AI 正承受財政壓力。據 TechCrunch 當日報道,公司同年被指燒錢過快,最近一次以可換股票據集資 2,500 萬美元,累計集資逾 1.25 億美元,但未能以更高估值完成新一輪融資,上一次估值為 10 億美元。
創辦人 Emad Mostaque 其後在 2024 年 3 月辭任行政總裁;同年 6 月 25 日,前 Weta Digital 行政總裁 Prem Akkaraju 獲委任為行政總裁。Stability AI 其後以影片模型為基礎,推出 Stable Video 3D 及 Stable Video 4D 等生成立體物件的模型。
暫時未有留言
提交留言即表示你已閱讀我們的私隱政策。