上載者聲稱是 Anthropic 未發布模型
Hugging Face 帳戶 burner22 在香港時間 10 月 23 日開設模型庫 numbat,上載 772 個權重檔案。說明頁聲稱,這是 Anthropic 下一代「Mythos 級」模型在預訓練中途的檢查點(checkpoint,即訓練途中保存的模型狀態),參數約 14 兆,共 114 層,檔案合共約 7.72 TB。
上載者在說明頁列出「可信」的理由:numbat 是 Anthropic 未發布模型的內部代號,而所有權重檔案格式一致、可以完整載入。至於檔案從何而來,說明頁只寫「不能透露更多」。
截至香港時間 11 月 2 日,模型庫錄得 5,846 次下載及 159 個讚好。
numbat 確是外洩原始碼中的代號
代號本身並非捏造。今年 3 月 31 日,Anthropic 在公開的 npm 套件中誤把 Claude Code 的完整原始碼一併發布。據 Engineer's Codex 整理,原始碼中有一句註解寫着「推出 numbat 時刪除這一段」,顯示 numbat 是一個尚未推出的模型。上載者正是借用這個真實代號,為檔案增加可信度。
43 組權重由名稱即可重現
香港時間 11 月 2 日凌晨,Hugging Face 用戶 FloxUnder 在模型庫的討論區發表審查結果:其中 43 組完整的權重張量(tensor,即模型內儲存數值的陣列),合共 730,368 個數值,只需用各自的名稱,就能逐個位元重新產生。
做法是把張量名稱經 SHA-256 雜湊後,用來設定 NumPy 亂數產生器的種子,再按固定公式換算。換言之,這些數值是由亂數產生器即場生成,而不是訓練得來。FloxUnder 其後先預測另外 21 組未讀取張量的 423,168 個數值,再下載比對,結果全部吻合。
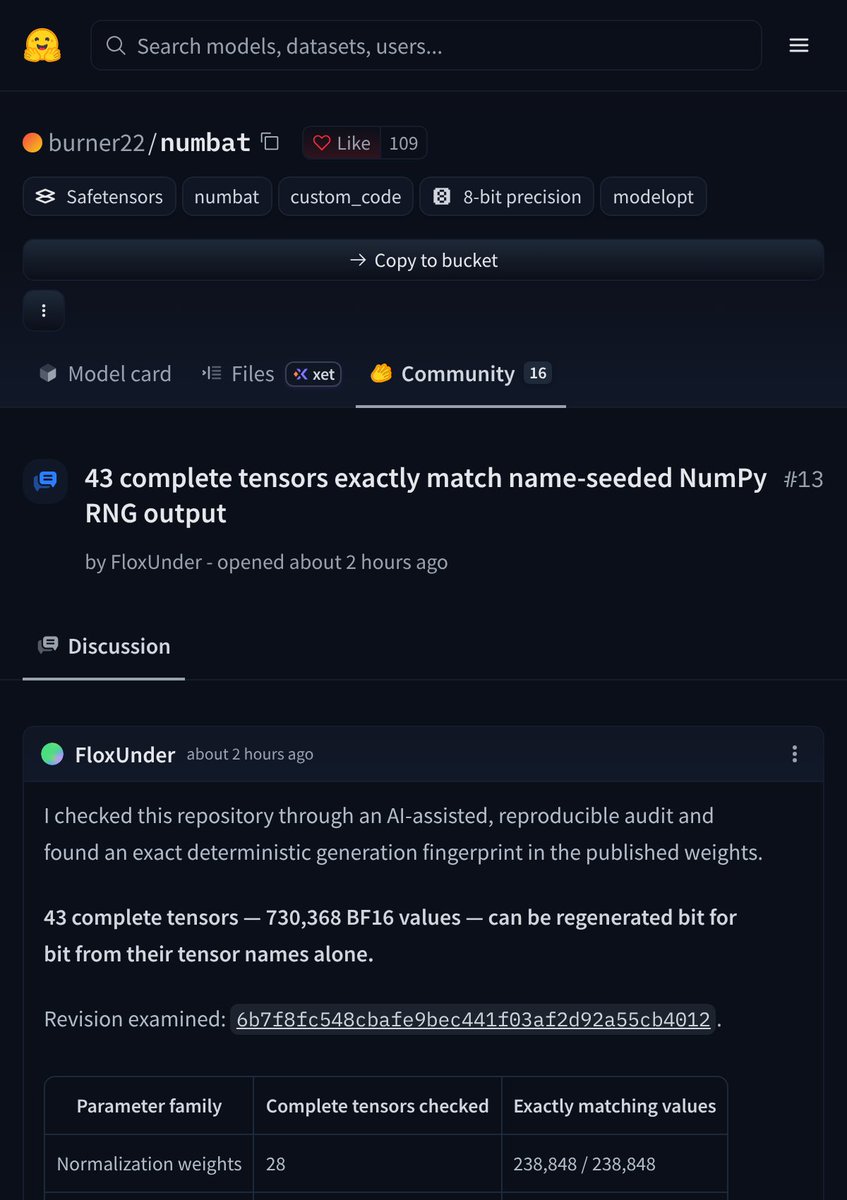
其他用戶隨後表示可以重現結果。有用戶補充,部分張量未能用同一公式重現,可能用了另一套公式或另加雜訊,但認為已足以證明模型是假的。
參數數目亦對不上
另一個破綻是參數數目。Hugging Face 自動統計的參數只有約 6.85 兆,不足上載者聲稱 14 兆的一半,早有用戶在討論區提醒其他人留意。說明頁強調檔案「格式一致」,但格式正確的亂數同樣可以完整載入,並不能證明權重來自真正的訓練。
暫時未有留言
提交留言即表示你已閱讀我們的私隱政策。