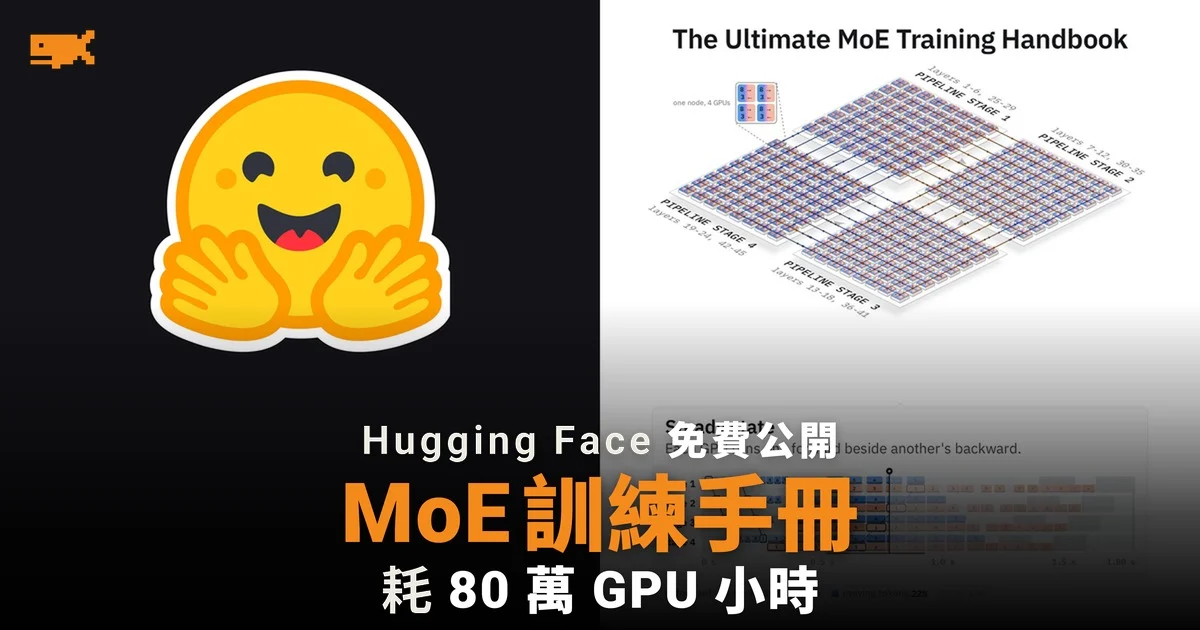
Hugging Face 免費公開 MoE 訓練手冊
Hugging Face 香港時間 11 月 6 日凌晨免費公開《The Ultimate MoE Training Handbook》,逐項講解如何大規模訓練「混合專家」(Mixture-of-Experts,MoE)模型。手冊由 Nouamane Tazi、Leandro von Werra 及 Hugging Face 聯合創辦人 Thomas Wolf 撰寫。Thomas Wolf 在社交平台表示,團隊為此自行花了 80 萬 GPU 小時做實驗,手冊約 7 萬字,附 55 幅互動圖表及可直接執行的程式碼。
MoE 模型把網絡拆成多個「專家」子網絡,每個 token(模型處理文字的基本單位)只經過其中少數幾個,所以模型總參數可以很多,每次實際動用的卻只是一小部分。以手冊第 2 章訓練的小型 MoE 為例,總參數 68.6 億,每個 token 只動用 12.2 億。
前 20 個開源模型有 18 個是 MoE
手冊引述 Artificial Analysis 的評分指,得分最高的 20 個開放權重模型中,有 18 個屬 MoE,只有排第 12 及第 13 的 Nanbeige4.3-33B 及 Qwen3.8 27B 是傳統的「密集」模型。DeepSeek V4.1 Flash、GLM-5.3、MiMo-V2.6-Pro 等五大實驗室的最佳模型都在其中。
Thomas Wolf 形容密集模型「基本上已經過去」,但訓練好 MoE 的知識「仍主要在少數團隊的腦中」。
手冊處理甚麼問題
手冊指,由密集模型轉做 MoE 會多出三個難題:決定每個 token 交給哪些專家的路由器、各專家之間的工作量平衡,以及專家分佈在不同 GPU 後,每一層都要在 GPU 之間交換 token。團隊在 AWS 的 H100 節點上做實驗,其中一次追蹤顯示,GPU 之間交換 token 佔了一個訓練步驟一半時間;另有兩次測試因網絡設定出錯,速度慢約 25 倍,記錄檔卻沒有任何錯誤。
手冊分為環境設定及第一次訓練、MoE 訓練剖析、由訓練到部署等章節,對象是曾在 GPU 叢集訓練過密集模型、想轉做 MoE 的團隊。它是 Hugging Face 前作《Smol Training Playbook》的續篇,前作以密集模型 SmolLM3 為主,只簡略提及 MoE。手冊建議預留一至兩日閱讀,並不建議用手機看。
暫時未有留言
提交留言即表示你已閱讀我們的私隱政策。