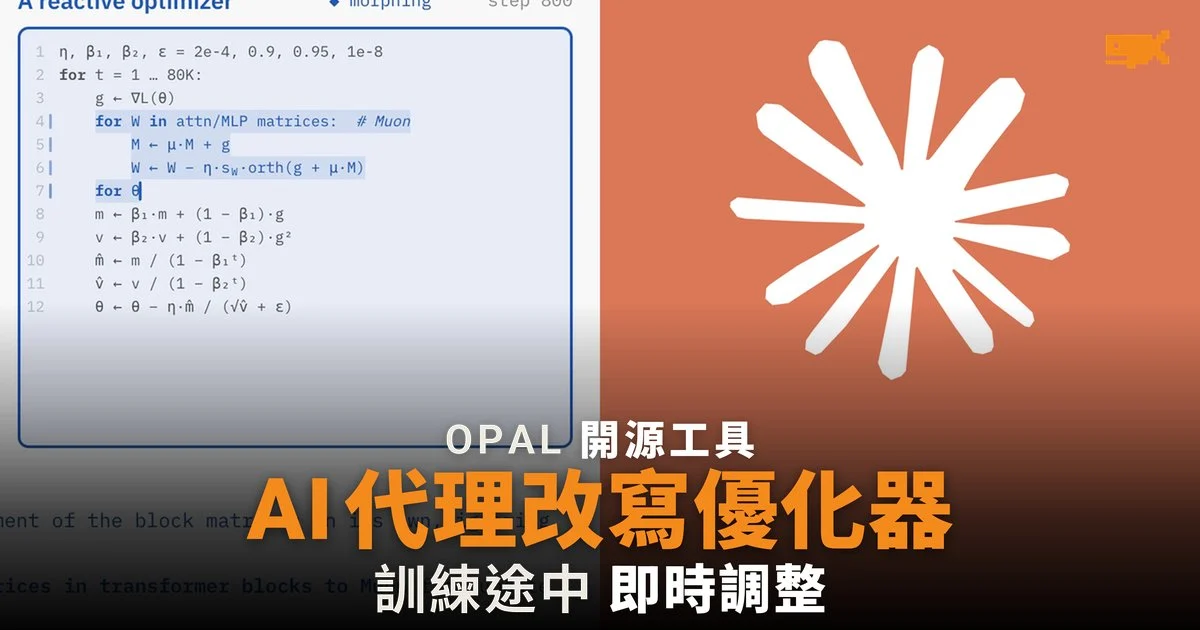
讓 AI 代理在訓練途中改寫優化器
研究員 Xingjian Bai、Jia-Hao Liang、Jayden Teoh 及 Vincent Sitzmann 香港時間 10 月 21 日深夜發表 OPAL(OPtimizer with an Agent in the Loop),一個開源的 PyTorch 優化器包裝器。一般神經網絡在開始訓練前已定好優化器,訓練期間不會再改;OPAL 則讓 AI 代理 Claude Code 在訓練途中每隔一段時間讀取訓練報告,再決定是否改寫兩段小程式:一段把梯度轉成每一步的參數更新,另一段量度代理想觀察的數據。
代理可以改動任何能寫成優化器程式的部分,包括各組參數的更新規則、學習率及其排程、動量、梯度裁剪,以及防止損失突然飆升的保護機制。它被要求不能碰模型、數據、損失函數、批次大小和評估方法。團隊在網誌中稱,在未有現成調校方案的語言及圖像任務上,OPAL 的表現追平或勝過能直接拿來用的最佳方案。
團隊公布的成績
據 Digg 整理的團隊數據,以 modded-nanogpt 改用中文、泰文或吉爾吉斯文數據集訓練,或把批次縮小至四分之一時,OPAL 在五個改編自排行榜的方案中排第一。這些比較都是在沒有專門調校方案的情況下進行。
實驗 | OPAL | 對照方案 |
|---|---|---|
ImageNet 圖像生成(FID,越低越好) | 1.83 | 2.18(官方方案) |
錯誤標籤的 CIFAR-10(測試準確率) | 78.6% | 73.5%(AdamW) |
阿姆哈拉文語言模型(每句位元,越低越好) | 81.11 | 83.48(官方方案) |
不過阿姆哈拉文一項,靠掃描學習率找到的固定方案得 80.89,比 OPAL 更好;讓 OPAL 由這個方案起步,成績再改善至 80.73。
代價與限制
團隊承認大部分實驗只跑過一次,少數跑了三次。訓練要停下來等代理決定,所需時間是固定方案的 1.30 至 4.39 倍。在刻意混入四段隨機圖像及標籤的 CIFAR-10 實驗中,OPAL 最終加入了攔截高損失批次的機制,但頭兩段仍令測試準確率分別跌了 50 和 66 個百分點。
GitHub 記錄亦顯示,舊版 OPAL 0.2.0 在一個已高度調校的 modded-nanogpt 基準上,成績比對照方案差。現時版本未支援多節點訓練、FSDP 及 DeepSpeed,而且代理無法重新開始或倒退訓練,只能在下一個決策點修正自己的程式。OPAL 以 MIT 授權開源,可用 pip 安裝。
暫時未有留言
提交留言即表示你已閱讀我們的私隱政策。