一個不生成文字的模型
前 OpenAI 研究員 Diogo Almeida 花了兩年,做出一個不會寫字的 AI 模型。他創辦的 TypeSafe AI 在香港時間周三(16 日)凌晨結束隱形開發期,公布首個模型 Jev,同時披露 4,000 萬美元種子輪融資,由創投基金 DCVC 領投。
Almeida 在公司網站自述,他在 OpenAI 參與建立了讓語言模型懂得跟從指示、與人對話的方法,那些研究最後成為 ChatGPT 背後的基礎。團隊頁面寫得更直接,指他共同發明 RLHF 與 InstructGPT,即通往 ChatGPT 及 GPT-4 的兩項方法。另外兩名聯合創辦人,分別是前 Meta/FAIR 研究工程師 Sasha Sheng 與連續創業者 Erik Gafni。
把答案改成選擇題
TypeSafe 形容 Jev 是首個 System One 模型,與 LLM 最大分別,在於它完全不逐個 token 生成文字。開發者交給它一段資料和一條預先定義好的問題,它直接回傳一個有類型的選項或分數,並附上機率與信心值。
公司解釋,一般軟件要用 LLM 做判斷,須先要求模型輸出結構化格式,再解析、驗證,然後才決定下一步;Jev 把這層轉換拿走。由於多條結構化問題可以同時評估,速度不再受生成長度拖住。訓練方法也是自己一套,稱為 Reinforcement Learning for Calibrated Decisions(RLCD),目標是令模型給出的機率,貼近它實際答對的比率。
代價是 Jev 不懂推理,也不會寫解釋。公司指它放棄了文字生成,換來的是不能虛構內容。
輸出免費,輸入每十億 token 42 美元
項目 | TypeSafe 公布的數字 |
|---|---|
回應時間 | 70 至 500 毫秒 |
速度 | 較同級前沿模型快 40 至 200 倍 |
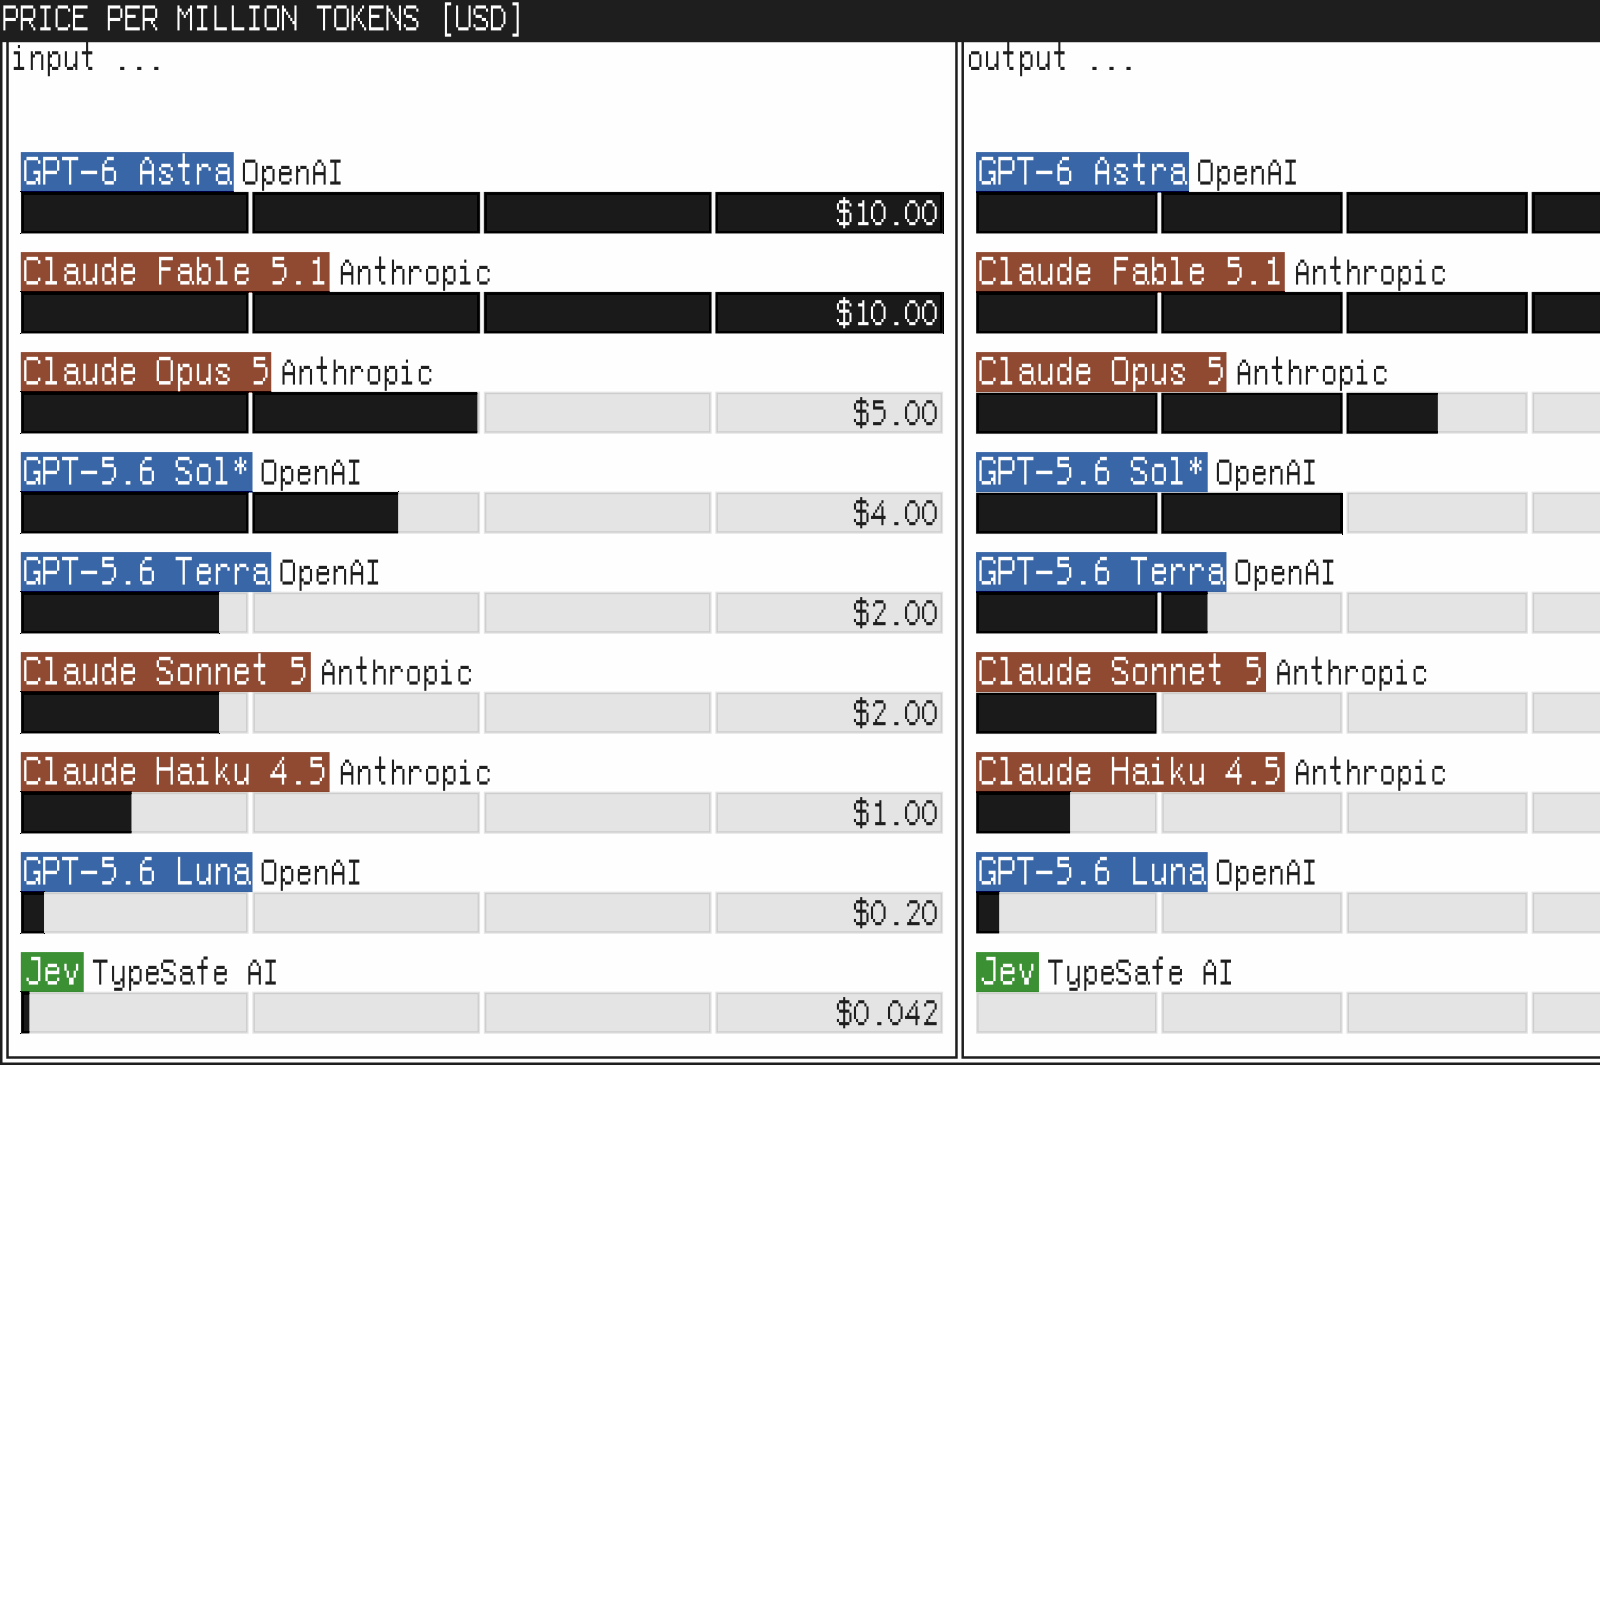
輸入價格 | 每百萬 token 0.042 美元,即每十億 token 42 美元 |
輸出價格 | 免費 |
公司在公布中把輸出價格寫成免費,理由是「便宜得不值得計算」。公布沒有交代這個價格會維持多久,只說現時免費。
獨立測試:快是真的,200 倍未必
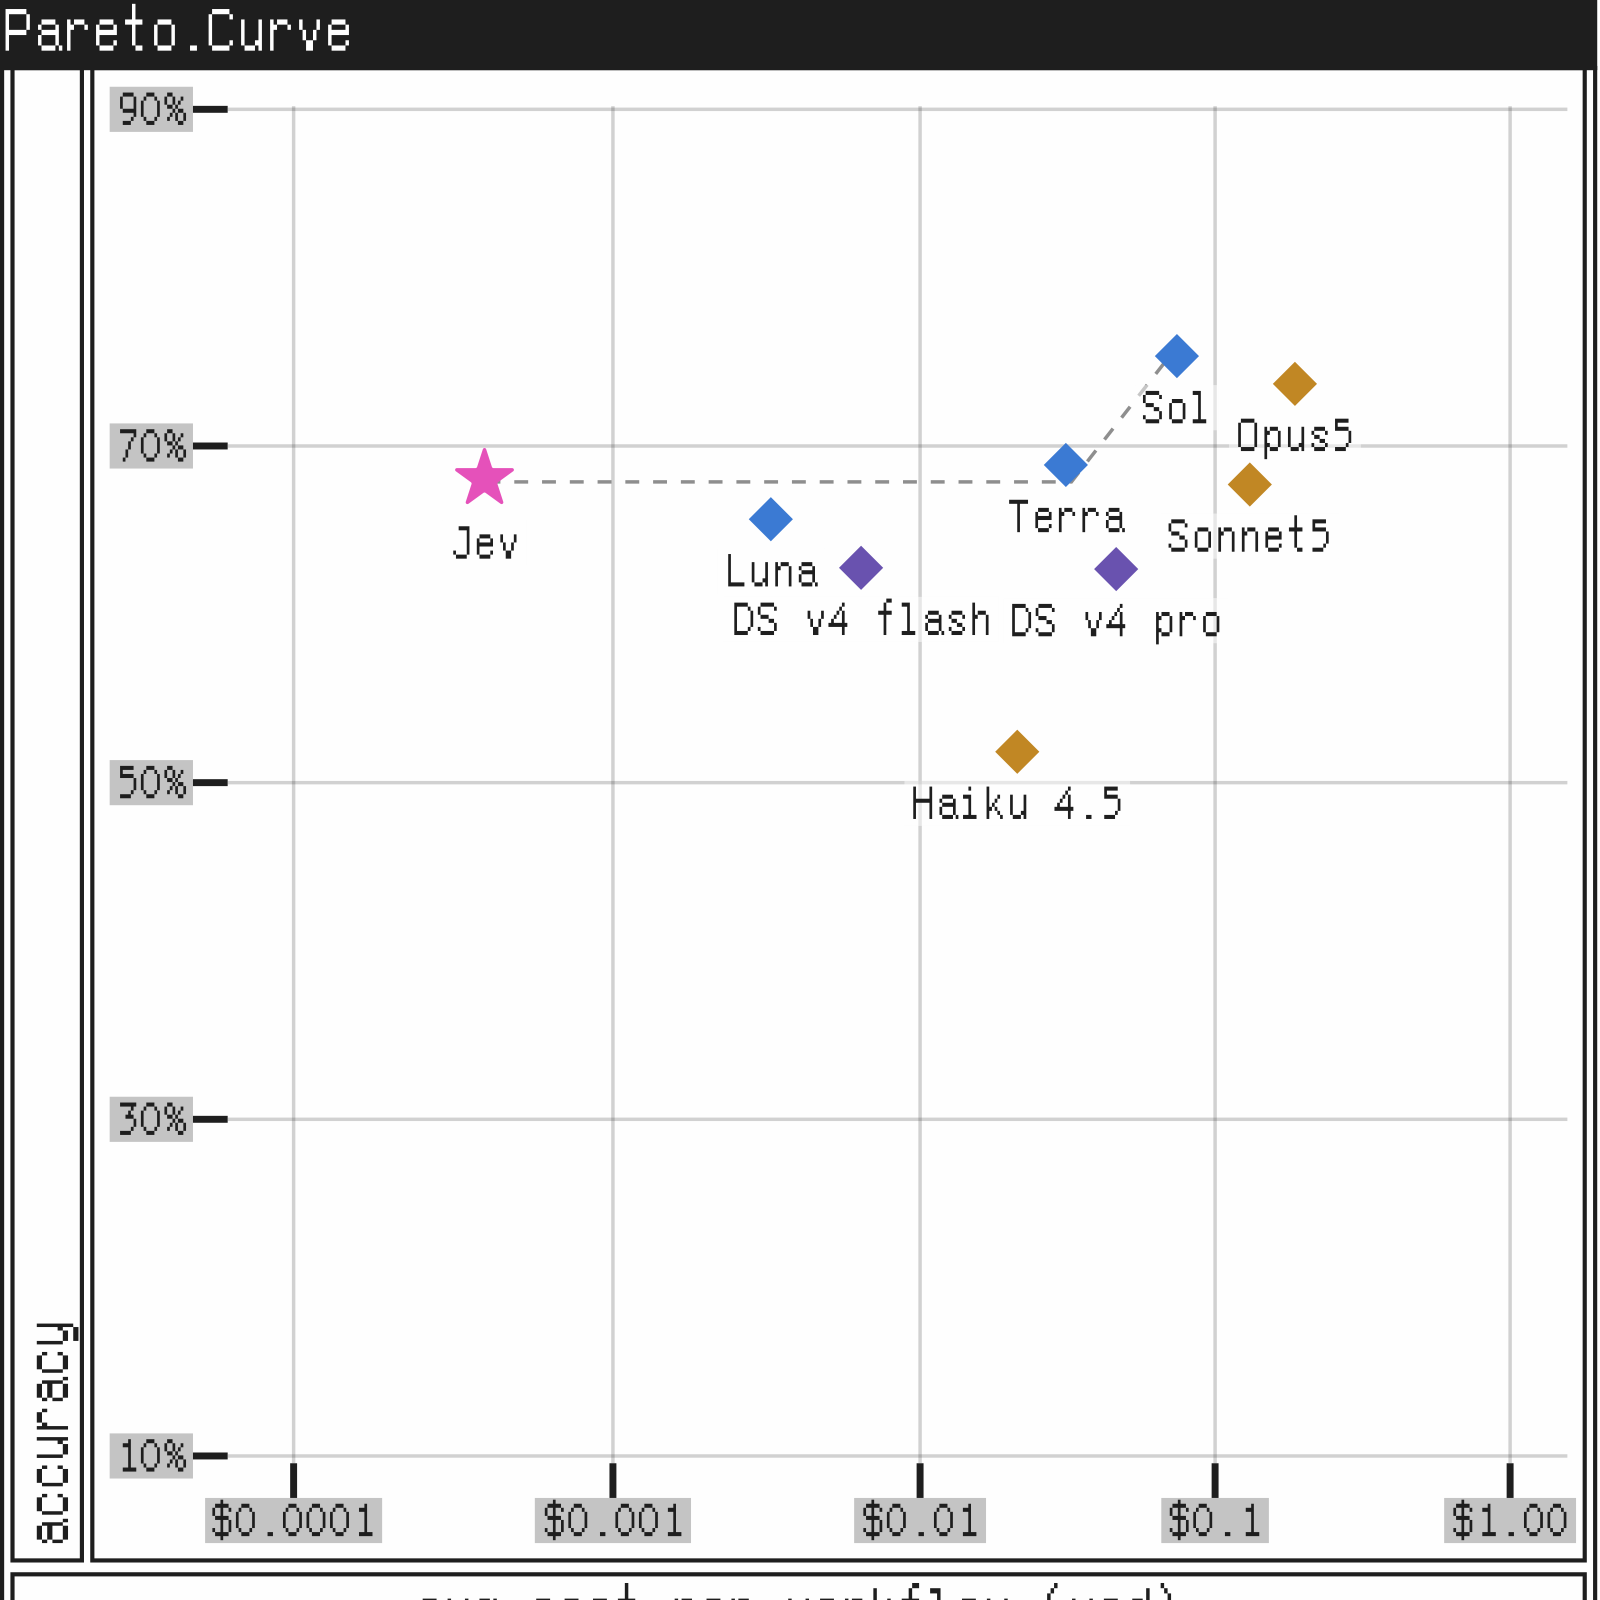
科技媒體 Every 的作者在公布當日實測,把 37 份文件、每份 21 條問題交給 Jev,不足 0.7 秒內取回 777 個判斷,總成本約四分之一美仙。不過同一篇測試把 Jev 與 Claude Fable 5.1 逐段對照,Jev 每段中位數 0.35 秒,對手 8.83 秒,實際差距約 25 倍,遠低於官方列出的上限。
準確度方面,作者在文章中埋下 7 個問題,Jev 找出 6 個,Fable 5.1 全數找齊,漏掉的是一個沒有交代的動作。他表示,在放進生產環境之前,自己會想做一次更徹底的準確度檢查。
翻查資料,Jev 這個名字取自 Jevons Paradox,即效率提升令使用量不跌反升。
來源
- Introducing System One Models and Jev(TypeSafe AI 原始公布)
- Mini-Vibe Check: TypeSafe's Jev Judged Everything I've Written in 0.7 Seconds(Every,獨立實測)
No comments yet
提交留言即表示你已閱讀我們的私隱政策。