哈佛研究指 AI 審稿在每項指標勝過人類專家
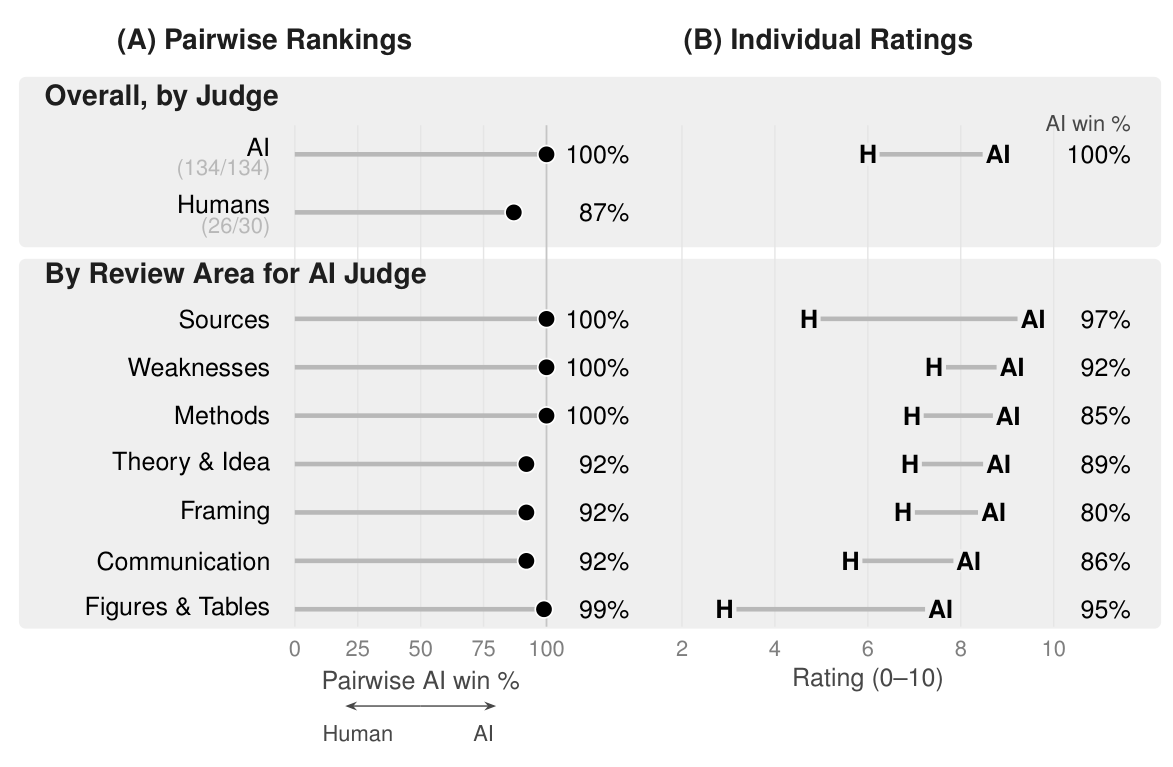
哈佛大學量化社會科學研究所所長 Gary King 與該所數據科學總監 Steven Worthington 10 月 22 日發表工作論文,指 AI 撰寫的論文評審意見,在他們能設計的每一項指標上都勝過人類專家的評審。研究比較 134 組針對同一份論文的 AI 與人類評審,由另一個 AI 模型擔任評判時,AI 評審在所有有定論的配對中勝出;三名前主要期刊編輯盲評時,AI 評審的勝出率為 87%。
人類評審來自質素最高的一批
據論文,人類評審全部來自量化社會科學研究所的 rapidPeer 服務。該服務自 2019 年起免費為教授在正式投稿前安排外校專家雙盲評審論文初稿,評審員獲優厚報酬,並須通讀全文、提出建設性意見。研究資料涵蓋 2019 至 2026 年的 124 份投稿及 134 份評審;74 名回覆問卷的作者中,88% 評所得評審為高或非常高質素。兩人稱,不知道有任何在更好條件下寫成的人類評審。
AI 評審由 Claude 撰寫、GPT 評判
論文指,AI 評審由 Anthropic 的 Claude Opus 4.8 以最高推理設定撰寫,評判則交由 OpenAI 的 GPT-5.5,令撰寫者與評判者來自不同模型家族。每組比較以兩種次序各評一次,兩次都選同一份評審才計勝出。三名前期刊編輯另外盲評隨機抽出的 10 組配對,事前不知道其中一份出自 AI。
按七個評審範疇計,AI 評判選 AI 評審的比率如下:
評審範疇 | AI 評審勝出率 |
|---|---|
參考文獻 | 100% |
弱點分析 | 100% |
研究方法 | 100% |
圖表 | 99% |
理論及構思 | 92% |
論述框架 | 92% |
表達 | 92% |
AI 評審出錯率約為人類三分之一
論文的穩健性測試顯示,AI 並非靠寫得更長取勝:在字數相若的 44 組配對中,AI 評審全數勝出。把評審內容與原稿逐點核對後,AI 評審對論文的陳述有 5.5% 被判錯誤,人類評審則為 15.9%,AI 評審亦沒有引用任何虛構文獻。換用另一套提示及評分準則的重複實驗中,416 次比較裡 AI 評審的勝出率為 97.1%(Claude 評判)及 94.2%(GPT 評判)。
研究建議期刊重新設計審稿流程
King 與 Worthington 在論文提出多項期刊政策選項,包括要求作者投稿時附上以期刊官方提示生成的 AI 評審及回應信,以至編輯不再例行邀請人類評審,令出版決定由數月縮短至數日。兩人同時警告,AI 可能令學術研究的論點和結論趨向同質化。論文又引述研究指,2026 年國際機器學習會議中,被分派到禁用 AI 政策的評審員有 22.5% 承認仍有使用。
研究未有測試的範圍
學術評論網誌 Entropy Clinic 10 月 23 日指出,研究比較的是投稿前的建設性意見,並非期刊決定是否接納論文的評審,而人類編輯的驗證樣本只有 10 組配對。論文亦承認,未有量度修訂後論文質素提升多少,亦未研究全面改用 AI 審稿的整體後果。
暫時未有留言
提交留言即表示你已閱讀我們的私隱政策。