開源模型在 OSWorld V2 勝過 Claude Opus 4.8
據 AI 初創 Simular 10 月 21 日發表的文章,其 Agent S4 為開源模型 Qwen3.8-27B 自動改寫一套操作電腦的介面後,模型在電腦操作測試 OSWorld V2 的 108 項任務中完成 21.3%,高於 Claude Opus 4.8 的 20.6% 及 GPT-5.5 的 13.0%。模型本身的權重及運行框架都沒有改動。
OSWorld V2 要求 AI 代理在真實桌面程式及自設網站上完成長流程工作。據 Snorkel AI 的排行榜介紹,當中 69.6% 的任務人類要花逾一小時完成,代理平均要走逾 250 步。
Agent S4 改的是介面,不是模型
Simular 指,Agent S4 本身不做任務,而是研究執行任務的 AI 代理,再改寫它們操作電腦的介面。介面即代理看見電腦及操作電腦的方式:圖形介面接收滑鼠點擊並回傳截圖,命令列介面接收指令並回傳文字。
Simular 舉例,代理透過截圖更新試算表時要逐格輸入,若有專用介面便可一次過寫入整批儲存格。系統由兩類代理組成,任務代理用一套介面庫嘗試任務,元代理閱讀任務過程後改寫介面庫,再以群體演化的方式,保留在驗證任務上得分較高的版本。
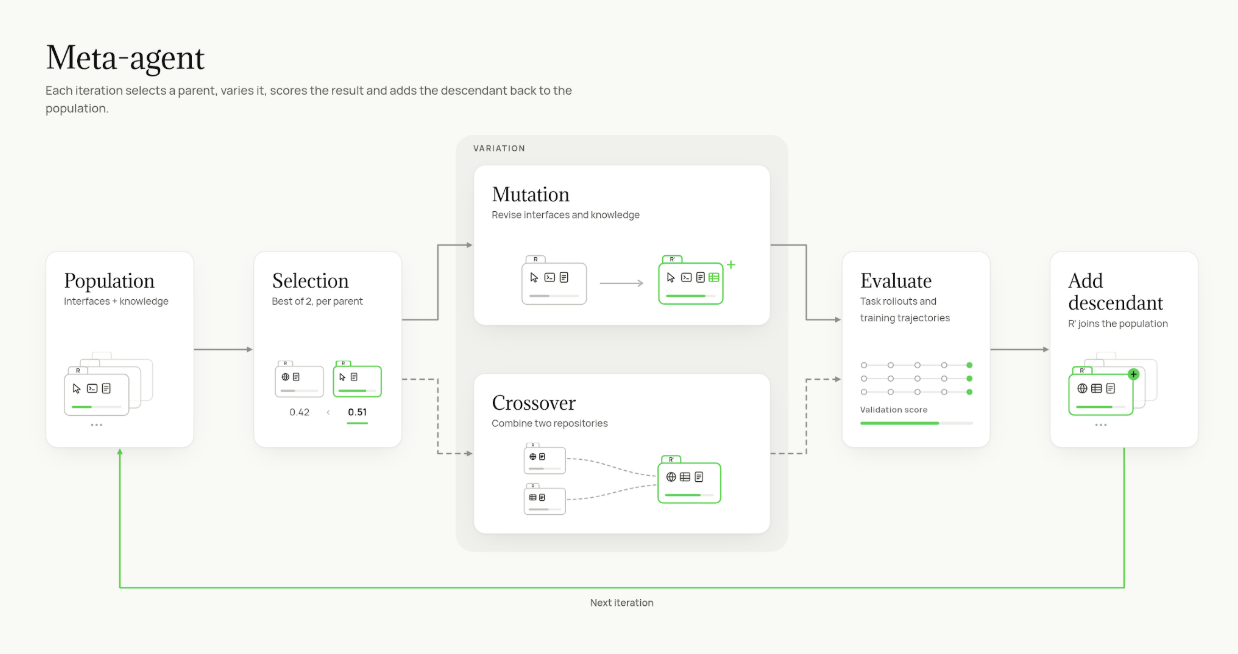
Simular 稱,元代理只從沒有對錯標記的合成訓練任務學習,從不接觸測試題目及驗證成績,以免介面庫變成答案紙。
每項任務成本 1.1 美元
據 Simular 公布的數字,加上演化介面後,Qwen3.8-27B 的完成率是同一模型用固定介面時的 3.8 倍,成本約為 GPT-5.5 的 4.3%。
模型 | 介面 | 完成率 | 每項任務成本 |
|---|---|---|---|
Qwen3.8-27B 加演化介面 | 演化 | 21.3% | 1.10 美元 |
Qwen3.8-27B | 固定 | 5.56% | 1.39 美元 |
Claude Opus 4.8 | 固定 | 20.6% | 72.40 美元 |
GPT-5.5 | 固定 | 13.0% | 25.50 美元 |
Simular 又用 169 項科學軟件任務測試,演化後的介面庫完成 99 項,起始版本則完成 93 項。
較新模型的分數高出一倍
據 Snorkel AI 的 OSWorld 2.0 排行榜,較新的 Claude Opus 5 最高完成率達 44.33%,GPT-5.6 Sol 為 27.34%,均高於 Agent S4 的 21.3%。Simular 比較的是排行榜上較舊的 Opus 4.8 及 GPT-5.5 成績,Agent S4 的成績亦未列入該排行榜。
Simular 的論文 10 月 20 日上載 arXiv,代碼已在其 Agent S 開源代碼庫公開。Simular 稱,介面是模型及框架以外的另一條改進途徑,同一方法亦可套用在更強的模型上。
暫時未有留言
提交留言即表示你已閱讀我們的私隱政策。