FrontierCS 2 測試 AI 能否勝過論文作者自己的程式
據 2026 年 10 月 21 日上載至 arXiv 的論文,UC Berkeley 的 Qiuyang Mang 和 Princeton University 的 Wenhao Chai 帶領數十名研究人員推出 FrontierCS 2,一套測試 AI 代理(能自行寫程式、執行和修改的 AI 系統)做電腦科學研究的基準測試。團隊從 48 篇已發表論文的公開程式碼中刪去論文的核心貢獻,被刪走的原版程式就是要跑贏的「人類基準」。題目橫跨 13 個領域,包括機器學習系統、高效能運算、數據庫、網絡安全和機械人。
AI 看不到論文,必須在每項指標都勝出才算過關
據 FrontierCS 官網,AI 代理只拿到被刪改的程式庫,每次提交修改會收到一個開發測試分數,但評分程式、隱藏測試和原版程式碼都不公開,每次限時 5 小時。最後 AI 自選一個版本,只有在每項指標、每組隱藏測試都勝過原版,才算通過。
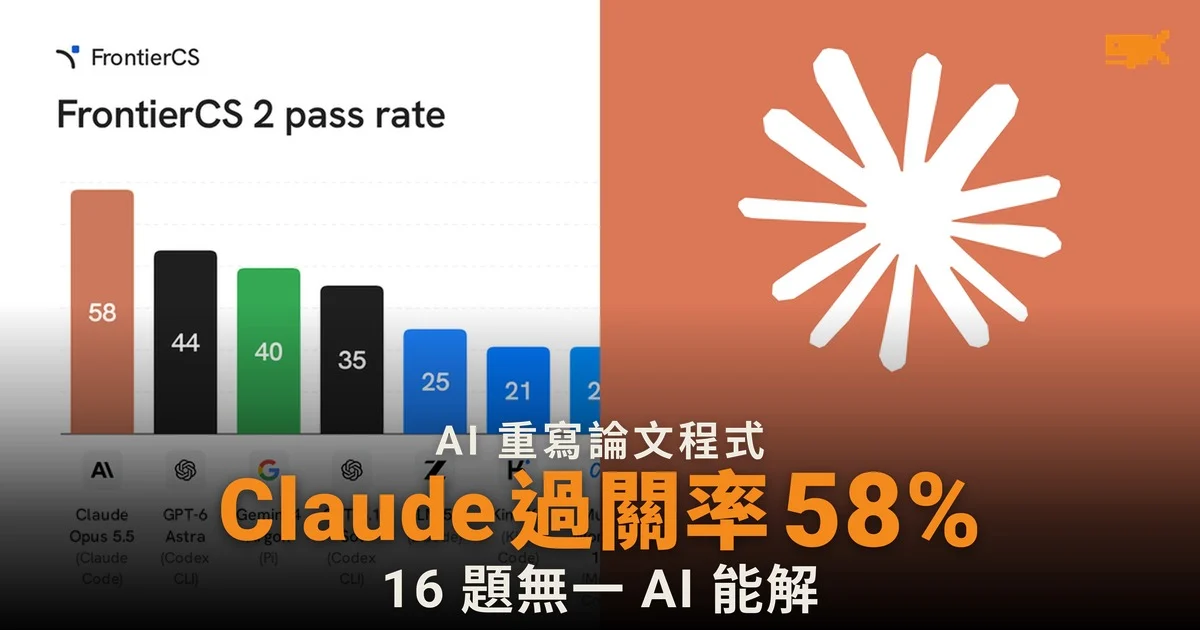
Claude Opus 5.5 通過 58%,16 題無一 AI 過關
據論文及官網排行榜,團隊測試了 12 個 AI 代理,每題各跑一次:
排名 | AI 模型(開發商) | 通過率 |
|---|---|---|
1 | Claude Opus 5.5(Anthropic) | 58%(28 題) |
2 | GPT-6 Astra(OpenAI) | 44%(21 題) |
3 | Gemini 4 Argon(Google) | 40%(19 題) |
4 | GPT-6.1 Sol(OpenAI) | 35% |
5 | GLM 5.3(Z.ai) | 25% |
48 題中有 16 題沒有任何 AI 通過。論文指,中位數難度的題目大約相當於最強 AI 的能力上限。官網亦註明,Gemini 4 Argon 有 10 次執行因模型供應商的內容過濾拒絕請求而中止。
總分較高也未必過關
官網舉例,在 KV Compaction 一題,Claude Opus 5.5 總分最高,亦高於原版,但在 24 篇文章中有 2 篇的準確度不及原版,所以不算通過。另一題 SVG-EAR 是一種用於影片生成的稀疏注意力方法,12 個 AI 都未能跑贏,最接近的 GPT-6 Astra 通過了 48 項檢查中的 43 項。也有 AI 做出改進:Muse Wonder 1.0 把私密數據庫查詢 QuarterPIR 每次查詢的數據量減少 27%,由 1,760 字節降至 1,280 字節。
完整測試一次約需 1,400 美元
據官網,以 Claude Opus 5.5 完整跑一次 48 題,約需 1,000 美元 API 費用、300 美元 GPU 運算和 100 美元 CPU 運算。團隊另有逾 100 題未公開的題目,日後公布。Kaggle 已把 FrontierCS 2 排行榜放上平台,並表示正與作者合作重現和核實成績。
來源
- FrontierCS 2: A Benchmark for Computer Science R&D(arXiv 論文)
- FrontierCS 2(FrontierCS 官網)
- FrontierCS 2 Leaderboard(Kaggle)
暫時未有留言
提交留言即表示你已閱讀我們的私隱政策。