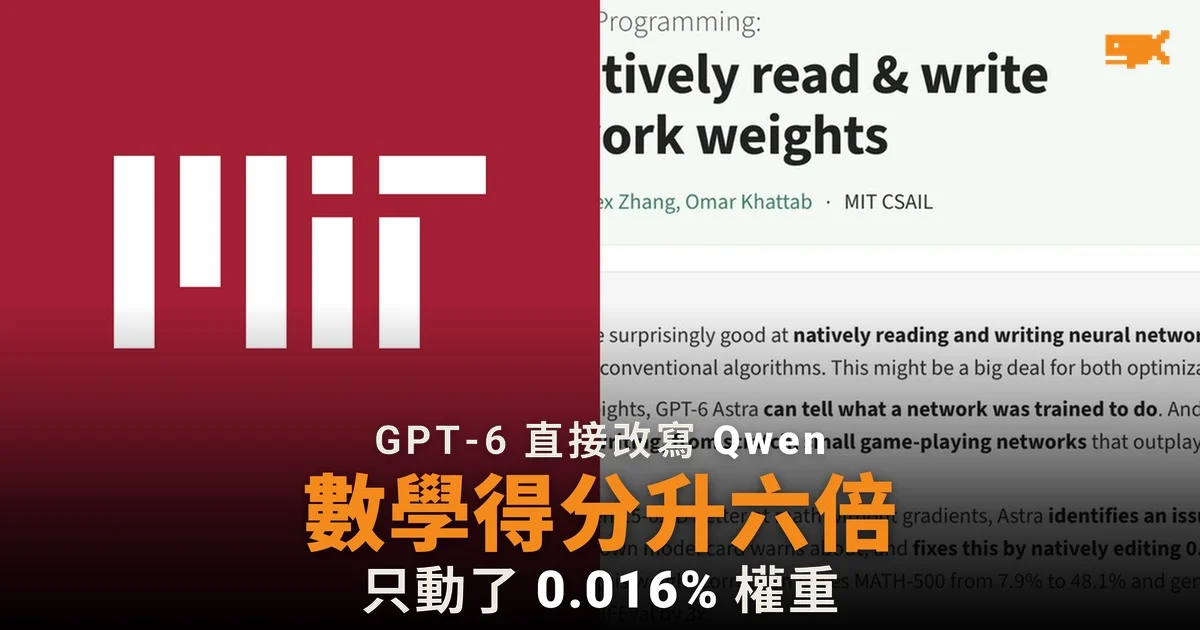
GPT-6 Astra 直接改權重,Qwen 數學分數升六倍
美國麻省理工學院電腦科學及人工智能實驗室(MIT CSAIL)的研究團隊在 11 月 2 日發表網誌,指他們用 OpenAI 的 GPT-6 Astra 直接修改阿里巴巴開源模型 Qwen3.5-0.8B 的權重,沒有用梯度下降,也沒有重新訓練,令模型在數學測試 MATH-500 的得分由 7.9% 升至 48.1%,約為原來的六倍。團隊把這種做法稱為「權重空間編程」(Weight-Space Programming)。
權重是決定神經網絡行為的大量數字。研究團隊表示,以往權重幾乎只能靠優化算法訓練出來,人類單看數字無從入手;今次的結果顯示,前沿大型語言模型開始能夠「讀懂」並直接改寫這些數字。
只改了 0.016% 的權重
據網誌,Qwen3.5-0.8B 在思考模式下很容易陷入「思考循環」,不斷重複同一段文字,難以給出答案。Qwen 的官方模型說明亦提醒,這個型號比同系列其他模型更容易出現思考循環。團隊統計,原版模型在 MATH-500 有 93% 的答案用盡 32,768 個 token 的上限。
團隊只給 Astra 一個可以讀取權重的 Python 環境、一批練習題,以及最多 50 次讓模型作答的機會,不准訓練,也不提供梯度資訊。Astra 追查到循環來自模型第 15 和第 19 層寫出的同一個方向,於是把這個方向從兩層各 64 個輸出欄中減去,合共改動 131,072 個權重,約佔模型 8 億個權重的 0.016%。
修改後,MATH-500 得分由 7.9% 升至 48.1%,GSM8K 由 13.8% 升至 67.1%;循環問題並不限於數學,所以衡量跟從指示能力的 IFEval 亦由 21.0% 升至 62.3%,約為三倍。用盡 token 上限的答案比例則由 93% 降至 33%。不過,若只給 Astra 10 次或 25 次作答機會,循環問題幾乎沒有改善。
未能令不會循環的模型變聰明
團隊亦用 Google 的 Gemma 3 270M 做對照。這個模型甚少陷入循環,答錯多數是計錯數或代數步驟出錯。Astra 的修改未能令它的 MATH-500 得分提升超過約一個百分點。團隊的結論是,修改權重可以移除令模型發揮不到原有能力的障礙,卻不能加入模型本來沒有的能力。
除了修正 Qwen,網誌亦報告 Astra 單看權重就能說出一個小型網絡是被訓練來玩哪一款遊戲,以及從零寫出能玩遊戲的網絡。團隊承認,現時能力仍受限於上下文長度和實驗工具,但認為這可能改變機械可解釋性和神經網絡優化等領域。
暫時未有留言
提交留言即表示你已閱讀我們的私隱政策。