2024 年 10 月 18 日,Meta 公開 Self-Taught Evaluator
據 Meta 官方網誌,旗下基礎人工智能研究部門 FAIR 在 2024 年 10 月 18 日發布一批研究成果,包括 Segment Anything 2.1、可混合文字及語音的 Spirit LM、加快大型語言模型回應速度的 Layer Skip,以及 Self-Taught Evaluator。Meta 形容 Self-Taught Evaluator 是一種生成合成偏好數據、用來訓練獎勵模型的新方法,過程不依賴人手標註。
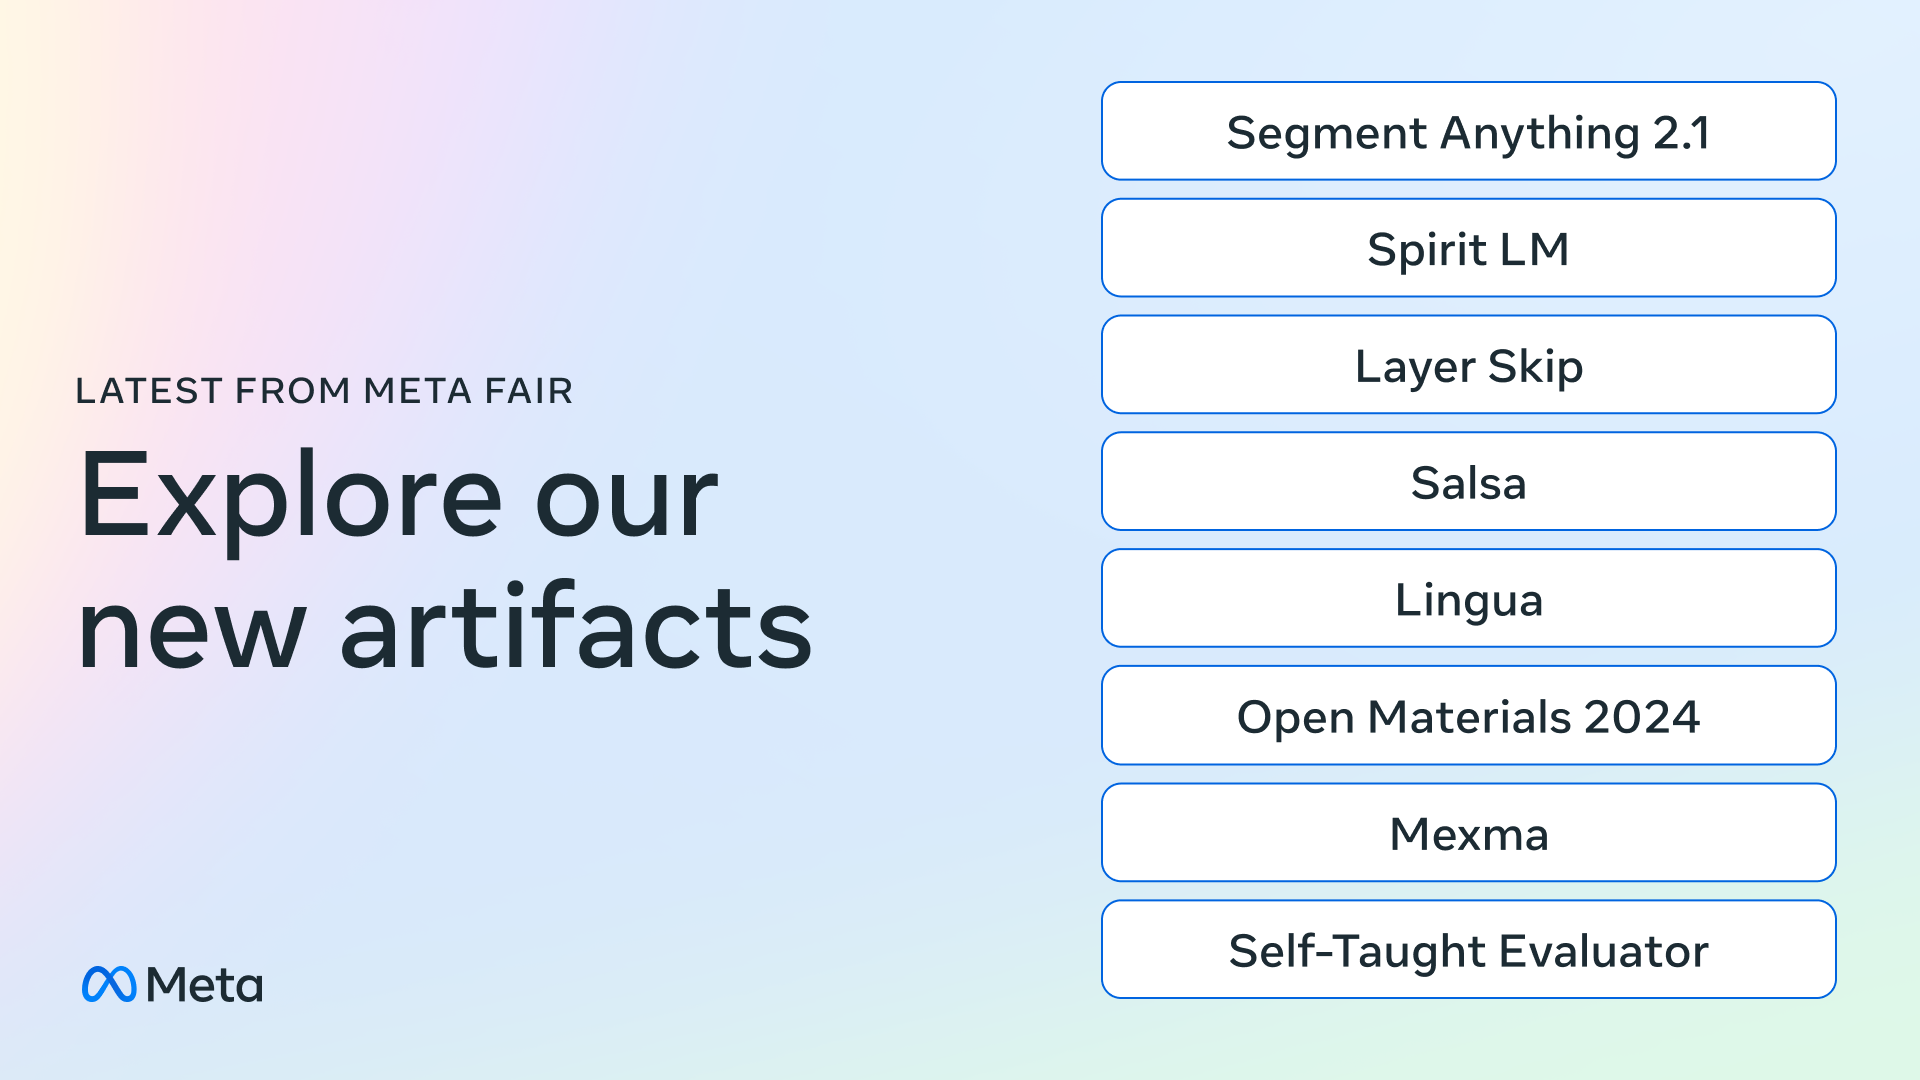
據路透社當日報道,這套方法在同年 8 月已以論文形式發表,10 月才連同程式碼、模型及數據集公開,供外界使用。
不用人手標註,評審模型怎樣學
評審模型(又稱獎勵模型)的工作,是比較兩個 AI 回答,判斷哪一個較好。傳統做法要聘請具專業知識的標註員逐題評分,成本高,而且模型進步後,舊數據很快過時。
據論文所述,研究團隊由未標註的指令出發,讓模型生成一好一差的對照答案,再訓練一個「以大型語言模型充當評審」的模型,先寫出推理步驟,再作最終判斷。每一輪都用上一輪改進後的判斷再訓練,反覆迭代。路透社指出,這與 OpenAI o1 採用的「思維鏈」技巧相同,即把複雜問題拆成較小的邏輯步驟。
成績:RewardBench 得分由 75.4 升至 88.3
RewardBench 是量度評審模型能否正確分辨答案好壞的基準測試。
項目 | RewardBench 得分 |
|---|---|
Llama 3 70B Instruct(訓練前) | 75.4 |
Self-Taught Evaluator | 88.3 |
Self-Taught Evaluator(多數投票) | 88.7 |
論文指出,這個成績勝過 GPT-4 等常用評審模型,並與以人手標註數據訓練的頂尖獎勵模型相若。
研究員:AI 愈強,愈需要自我檢查
據路透社報道,研究員 Jason Weston 表示:「我們希望,隨着 AI 愈來愈超越人類,它檢查自己工作的能力會愈來愈好,最終比一般人做得更好。」他認為,自學及自我評估的能力,是 AI 達到超越人類水平的關鍵。兩名參與研究的 Meta 研究員對路透社說,以 AI 可靠地評審 AI,或可為打造能從錯誤中學習的自主 AI 代理 鋪路。
路透社指出,若 AI 能可靠地評審 AI,業界或可減少依賴「人類回饋強化學習」(RLHF),即由人類標註員為模型答案評分的訓練程序。Google 及 Anthropic 亦曾發表「AI 回饋強化學習」(RLAIF)研究,但路透社當時指出,這兩家公司一般不會把模型公開給外界使用。
No comments yet
提交留言即表示你已閱讀我們的私隱政策。