阿里巴巴開源程式碼已出現未發布的 Qwen4 型號
據 GitHub 上的合併紀錄,阿里巴巴的開源編程 AI 代理 Qwen Code 的程式庫在 2026 年 10 月 28 日合併了一項改動,把整個 Qwen4 世代的上下文長度(模型一次能讀入和處理的文字量)預設為 100 萬個 token。改動附帶的測試列出 qwen4-max、qwen4-plus、qwen4-coder-plus 和 qwen4.5-max 等型號名稱;另一組多模態功能的測試,已把 qwen4-omni-120b-think 用作對話所用的模型。
截至 2026 年 11 月 3 日,這些名稱仍留在程式庫的主分支。阿里巴巴至今未正式發布任何 Qwen4 模型。
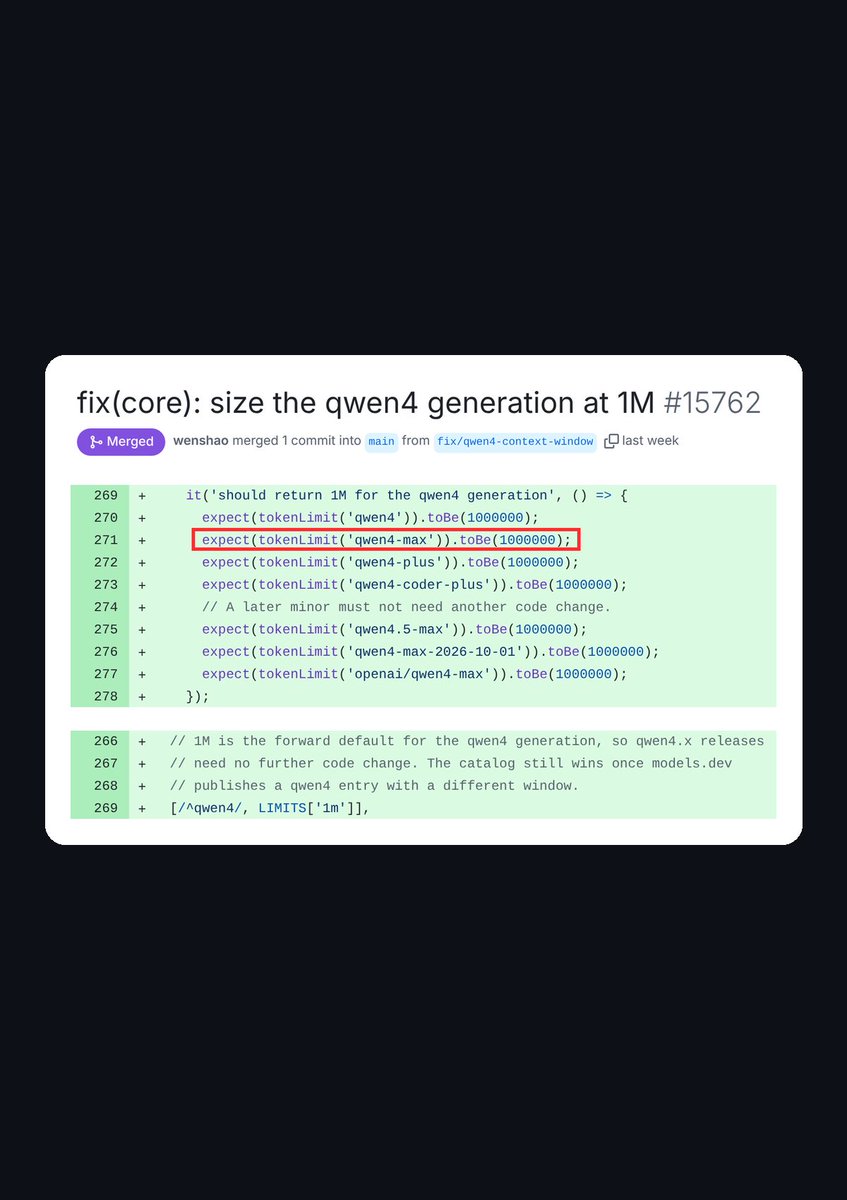
改動由阿里雲技術負責人提交
這項編號 #15762 的改動由 GitHub 帳戶 wenshao 提交並合併。該帳戶的個人資料顯示,持有人是阿里雲 DataWorks 技術負責人 Shaojin Wen,亦是阿里巴巴開源項目 fastjson 的作者。
改動說明指出,Qwen Code 判斷上下文長度的規則只涵蓋到 qwen3.x,而公開模型目錄 models.dev 和程式內置的目錄都沒有任何 qwen4 型號,所以整個 Qwen4 世代會被當作只有 262,144 個 token,令自動壓縮對話過早啟動。說明又寫道,qwen4-omni-120b-think 已在多模態測試中用作對話模型,「所以這些型號並非假設」。
程式碼註解把 100 萬稱為 Qwen4 世代的「預設值」,一旦 models.dev 刊出不同的數字,就以目錄為準。換言之,100 萬是開發者設定的預設,並非阿里巴巴公布的規格。
阿里巴巴確認了甚麼
阿里巴巴在 Hugging Face 公開的資料,是目前唯一出自官方、提到 Qwen4 的文件:
日期 | 事件 | 出處 |
|---|---|---|
2026 年 8 月 24 日 | 推出 Qwen3.8-Flash-Next,模型卡形容它是「支撐 Qwen4 的架構的實驗性預覽」,設定檔把模型類型寫作 qwen4_exp | Hugging Face 模型卡 |
2026 年 9 月 22 日 | 雲棲大會新聞稿表示 Qwen 4「正在訓練」 | 據 OmniaKey 整理 |
2026 年 10 月 28 日 | Qwen Code 合併 Qwen4 上下文長度的改動 | GitHub |
據分析網站 OmniaKey 在 2026 年 11 月 1 日的核查,Hugging Face、阿里雲的模型服務平台 Model Studio 和模型聚合平台 OpenRouter 當時都未列出任何 Qwen4 模型。網上流傳的 Qwen4-Max、Plus、Flash 和 27B 四個型號,以及「下星期推出」的說法,都出自第三方網站,阿里巴巴未有確認。
qwen4-coder-plus 和 qwen4-omni-120b-think 兩個名稱,不在第三方流傳的四個型號之內。阿里巴巴未有交代這些型號是否會推出。
來源
- fix(core): size the qwen4 generation at 1M #15762(GitHub,原始文件)
- Qwen3.8-Flash-Next(Hugging Face,阿里巴巴模型卡)
- Qwen 4 Release Date: What Alibaba Has Confirmed So Far(OmniaKey)
暫時未有留言
提交留言即表示你已閱讀我們的私隱政策。