SemiAnalysis 推出 GDPx 基準測試,最強模型只得 12%
半導體研究機構 SemiAnalysis 在香港時間 2026 年 11 月 2 日發表 GDPx,一套量度 AI 代理(能自行操作工具完成多步工作的 AI)在 11 個高價值行業表現的基準測試,表現最好的 Anthropic Claude Opus 5.5 平均得分亦只有 12.0%。
GDPx 涵蓋晶片設計、網絡安全、生物、金融、法律、量化交易、AI 自我改進研究(RSI)、硬件設計、材料科學、AI 對齊及軟件工程。總分把 11 個領域平均計算,每個領域權重相同,每題取三次嘗試的平均。
Claude Opus 5.5 居首,Gemini 4 Carbon 以 10.9% 排第二
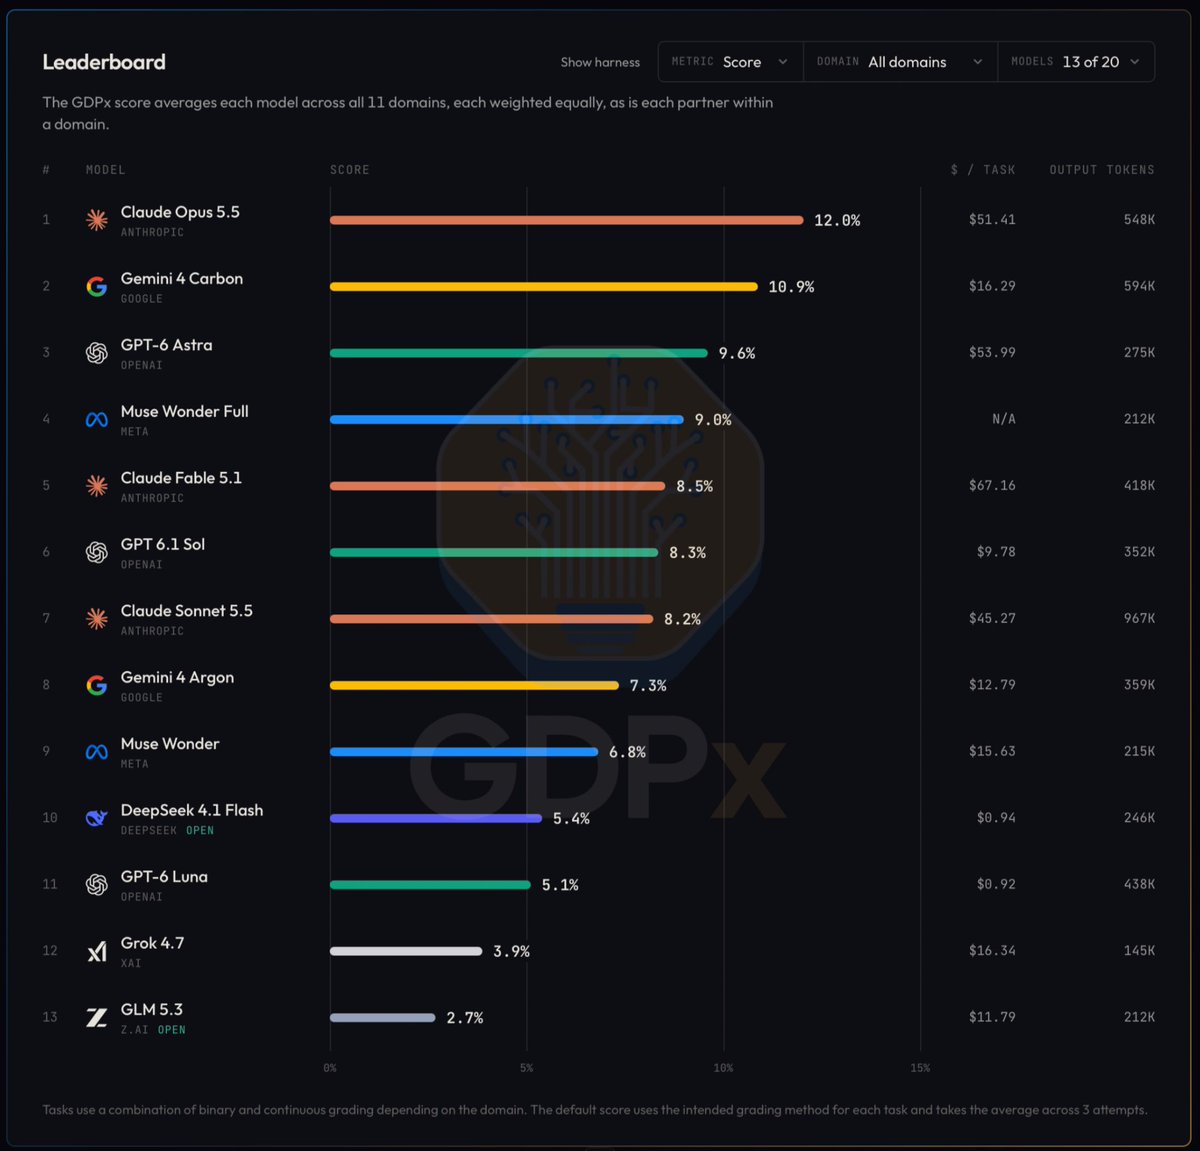
排行榜顯示的 13 個模型中,Opus 5.5 以 12.0% 居首,Google 的 Gemini 4 Carbon 以 10.9% 排第二,OpenAI 的 GPT-6 Astra 以 9.6% 排第三,Meta 的 Muse Wonder Full 以 9.0% 排第四。
排名 | 模型 | 公司 | 得分 | 每題成本 |
|---|---|---|---|---|
1 | Claude Opus 5.5 | Anthropic | 12.0% | 51.41 美元 |
2 | Gemini 4 Carbon | 10.9% | 16.29 美元 | |
3 | GPT-6 Astra | OpenAI | 9.6% | 53.99 美元 |
4 | Muse Wonder Full | Meta | 9.0% | 未有列出 |
11 | GPT-6 Luna | OpenAI | 5.1% | 0.92 美元 |
SemiAnalysis 指 Opus 5.5 在量化交易、硬件設計及晶片設計三個領域勝出。Gemini 4 Carbon 在生物及軟件工程領先,文章認為它的生物得分高,可能與安全分類器較寬鬆有關。GPT-6 Astra 在 RSI 及材料科學領先,網絡安全最強的則是 Muse Wonder Full。
安全分類器拉低 Opus 5.5 及 GPT-6 Astra 的總分
SemiAnalysis 指出,Opus 5.5 和 GPT-6 Astra 的總分被各自的安全分類器(自動攔截高風險請求的過濾機制)壓低,因為部分網絡安全及生物題目被拒絕作答;若剔除網絡安全、生物及 AI 對齊三個領域,排名會有變化。
金融及法律題目以二元評分計算全部零分
金融及法律是最難的兩個領域,以原定的二元評分(全部做對才得分)計算,所有模型都是 0%,排行榜因此改報部分得分的平均。金融的 24 條題目全部取材自一宗真實的私募基金收購交易,操作環境約有 4,000 份匿名文件。其中一條法律題目要求模型代表 B 輪融資的領投方修訂公司章程,四個模型共 20 次嘗試,沒有一份修訂稿可用;部分得分方面,Opus 5.5 平均 44%,GPT-6 Astra 平均 25%。
GDPx 針對 OpenAI GDPval 的不足而設計
SemiAnalysis 批評 OpenAI 在 2025 年 9 月推出的 GDPval 只有非互動題目,沒有可操作的環境,評分又依賴評分準則,人類專家之間的一致率只有 71%。GDPx 的題目由 14 間專門數據公司提供。
暫時未有留言
提交留言即表示你已閱讀我們的私隱政策。