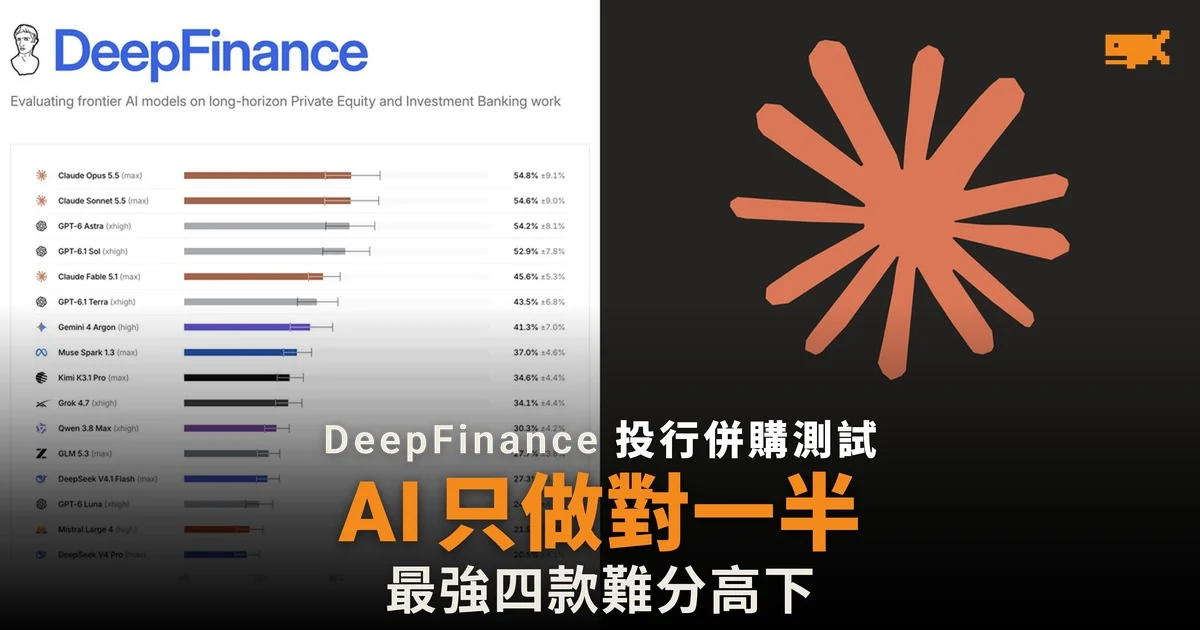
最強 AI 做投行併購工作,只達專家清單約 55%
美國 AI 研究實驗室 Julius Research 於 11 月 6 日早上(香港時間)發布 DeepFinance 測試,以 21 項私募股權(PE)及投資銀行(IB)工作考核 AI 代理。每項工作平均要專業人員花 27.1 小時完成,結果表現最好的 Claude Opus 5.5 只達到評分清單上 54.8% 的要求。
測試按真實交易資料設計
據 Julius Research 的說明,題目由曾任職 Evercore、摩根大通及瑞銀等公司,或來自哈佛商學院及華頓商學院的專業人員撰寫及覆核,用的是經匿名處理的真實交易資料。每題附一個平均有 19 個檔案的資料室,包括試算表、電郵、會議紀錄及條款書,內容常有互相矛盾的地方,要 AI 自行判斷取捨。題目涵蓋估值、盡職審查、承銷及財務模型四類工作。
評分不只看最終數字,每題平均有 84 項準則,分三類檢查:輸出是否正確、有沒有找到並用上相關證據,以及假設和決定是否有證據支持。測試共評核 20 個模型設定,每題各做 10 次。
頭四名分不出高下,價錢卻差十倍
模型(設定) | 開發商 | 得分 | 每題 API 成本 |
|---|---|---|---|
Claude Opus 5.5(max) | Anthropic | 54.8% | 8.63 美元 |
Claude Sonnet 5.5(max) | Anthropic | 54.6% | 6.94 美元 |
GPT-6 Astra(xhigh) | OpenAI | 54.2% | 4.55 美元 |
GPT-6.1 Sol(xhigh) | OpenAI | 52.9% | 0.81 美元 |
Claude Fable 5.1(max) | Anthropic | 45.6% | 12.02 美元 |
Gemini 4 Argon(high) | 41.3% | 2.85 美元 |
Julius Research 指,頭四名在統計上無法區分高下,但 GPT-6.1 Sol 每題成本只約 0.81 美元,約為 Claude Opus 5.5 的十分之一。Claude Fable 5.1 是測試中最貴的模型,得分卻不足五成,Julius Research 形容用在金融工作上「不值這個價」。Anthropic 及 OpenAI 的模型包辦頭六名,兩家以外表現最好的 Gemini 4 Argon 只得 41.3%,最差的一組只有一成多。
計數不難,難在判斷
Julius Research 的分析指,AI 失分多在判斷而非計算。例如在一項貸款工作中,AI 用錯了盈利數字,之後的借貸能力計算雖然算得正確,結果仍然錯。另一項收購工作中,只要更改交易完成日期,所需出價就可減少 125 萬美元,但所有前沿模型的嘗試都錯過了這筆節省,即使部分已找到買方有權選擇日期的條款。
科技媒體 RuntimeWire 指,金融機構正被推銷用 AI 代理做盡職審查及估值,這個缺口是買家讓 AI 處理真實交易前要計算的代價。需要留意的是,這次測試由 Julius Research 自行設計及執行,暫未見其他團隊獨立重複測試。
暫時未有留言
提交留言即表示你已閱讀我們的私隱政策。