開源模組令 RTX 4090 張量運算指令速度翻倍
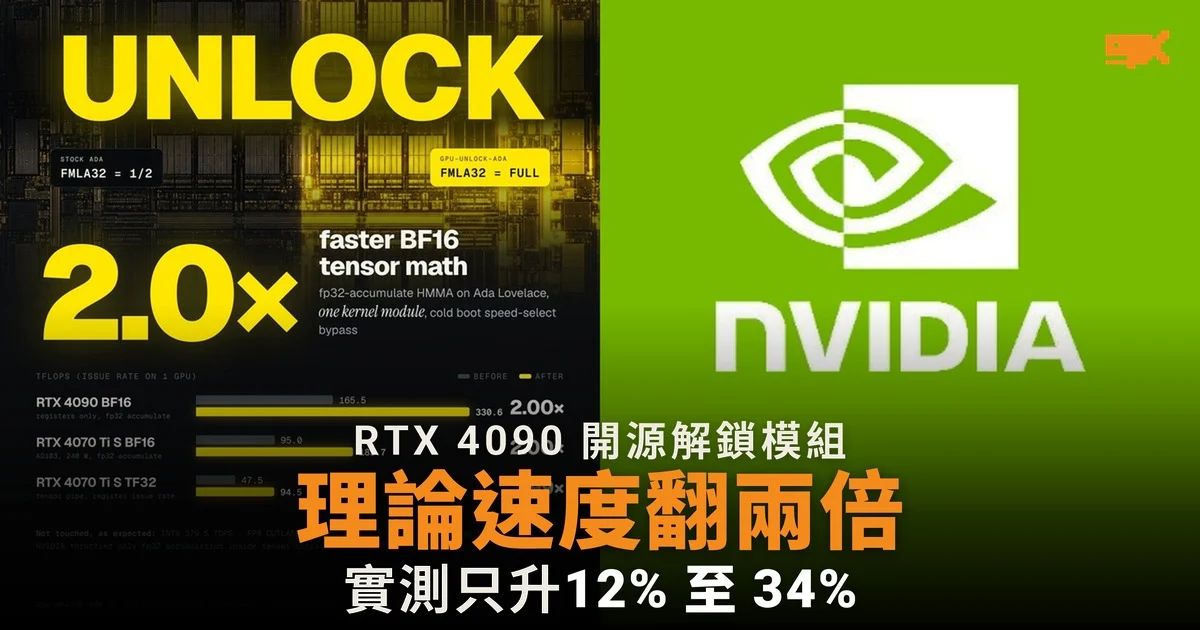
據 GitHub 項目 gpu-unlock-ada 的說明,帳號 JustAResearcher 在 2026 年 10 月 23 日(美國時間)公開一個 Linux 核心模組,在一張 RTX 4090 上把 FP16 和 BF16 張量運算(以 FP32 累加)的指令速度由每秒約 165 兆次提升至約 331 兆次,約為兩倍。
張量核心(Tensor Core)是 Nvidia 顯示卡上專門處理 AI 運算的單元。項目指,消費級 RTX 40 系列在這類運算上被設定為半速,模組在開機時、Nvidia 官方驅動程式載入前更改晶片的速度設定,之後照常使用未經修改的官方驅動程式。項目截至 10 月 25 日已有逾 1,500 個 GitHub 星號。
顯示卡 | 運算 | 解鎖前 | 解鎖後 |
|---|---|---|---|
RTX 4090 | FP16,FP32 累加 | 165.6 TF/s | 331.6 TF/s |
RTX 4090 | BF16,FP32 累加 | 165.5 TF/s | 330.6 TF/s |
RTX 4070 Ti SUPER | FP16,FP32 累加 | 95.0 TF/s | 189.9 TF/s |
實際矩陣運算只快 12% 至 34%
項目說明列出的另一位用戶獨立測試顯示,同一張 RTX 4090 在同一 450 瓦功耗上限下,指令速度同樣約翻一倍,但以 Nvidia cuBLAS 函式庫做實際矩陣乘法(GEMM,AI 訓練和推理最常用的運算)時,FP16 只快 12% 至 34%,BF16 在兩種矩陣大小下快 16% 至 20%,在 4096³ 大小下幾乎沒有分別。
開發者社群 DEV 10 月 25 日刊出的分析亦以「實際 GEMM 提升為 12% 至 34%」為題,提醒兩倍數字只是指令層面的理論速度,不等於整個 AI 程式的加速。
項目亦指,INT8 和一般 FP32 運算速度沒有改變;在 RTX 4070 Ti SUPER 上試行的 FP8 矩陣運算,解鎖前後只差 0.3%。
支援的顯示卡仍然有限
模組自動支援 RTX 4090;RTX 4070 Ti SUPER 和 RTX 4060 Ti 16GB 屬實驗性質,各自只在一張卡上驗證過,需要用戶手動開啟。RTX 30 系列的支援沿用上游項目,未經這個分支重新驗證。專業級 RTX A 系列和數據中心晶片不在支援之列。
gpu-unlock-ada 建基於 Zagitta 10 月 18 日公開的 gpu-unlock 項目,以及 Hugging Face 用戶 TOTORONG 發表的韌體程式。法國科技網站 Frandroid 10 月 25 日報道此事時,以「Nvidia 是否限制了 GeForce RTX 40 的效能」為題。項目說明強調,現有數字只來自單張顯示卡的測試,並非長時間穩定性測試。
來源
- JustAResearcher/gpu-unlock-ada(GitHub,項目說明及測試數據)
- RTX 4090 "2x FP16" unlock: real GEMM gains are 12 to 34%(DEV Community)
- Nvidia bride-t-il ses GeForce RTX 40 ? Un hack fait sauter le verrou(Frandroid)
暫時未有留言
提交留言即表示你已閱讀我們的私隱政策。