50 項 AI 研究結論,44% 已不再成立
史丹福大學研究員 Owen Queen 及 James Zou 在 2026 年 11 月 2 日發表研究,重新測試 50 項被廣泛引用、關於大型語言模型(LLM)行為的研究結論,涵蓋偏見、幻覺、奉承用戶、越獄等範疇。結果發現,大部分結論在發表後約 15 個月內已不再成立,或效果明顯減弱。
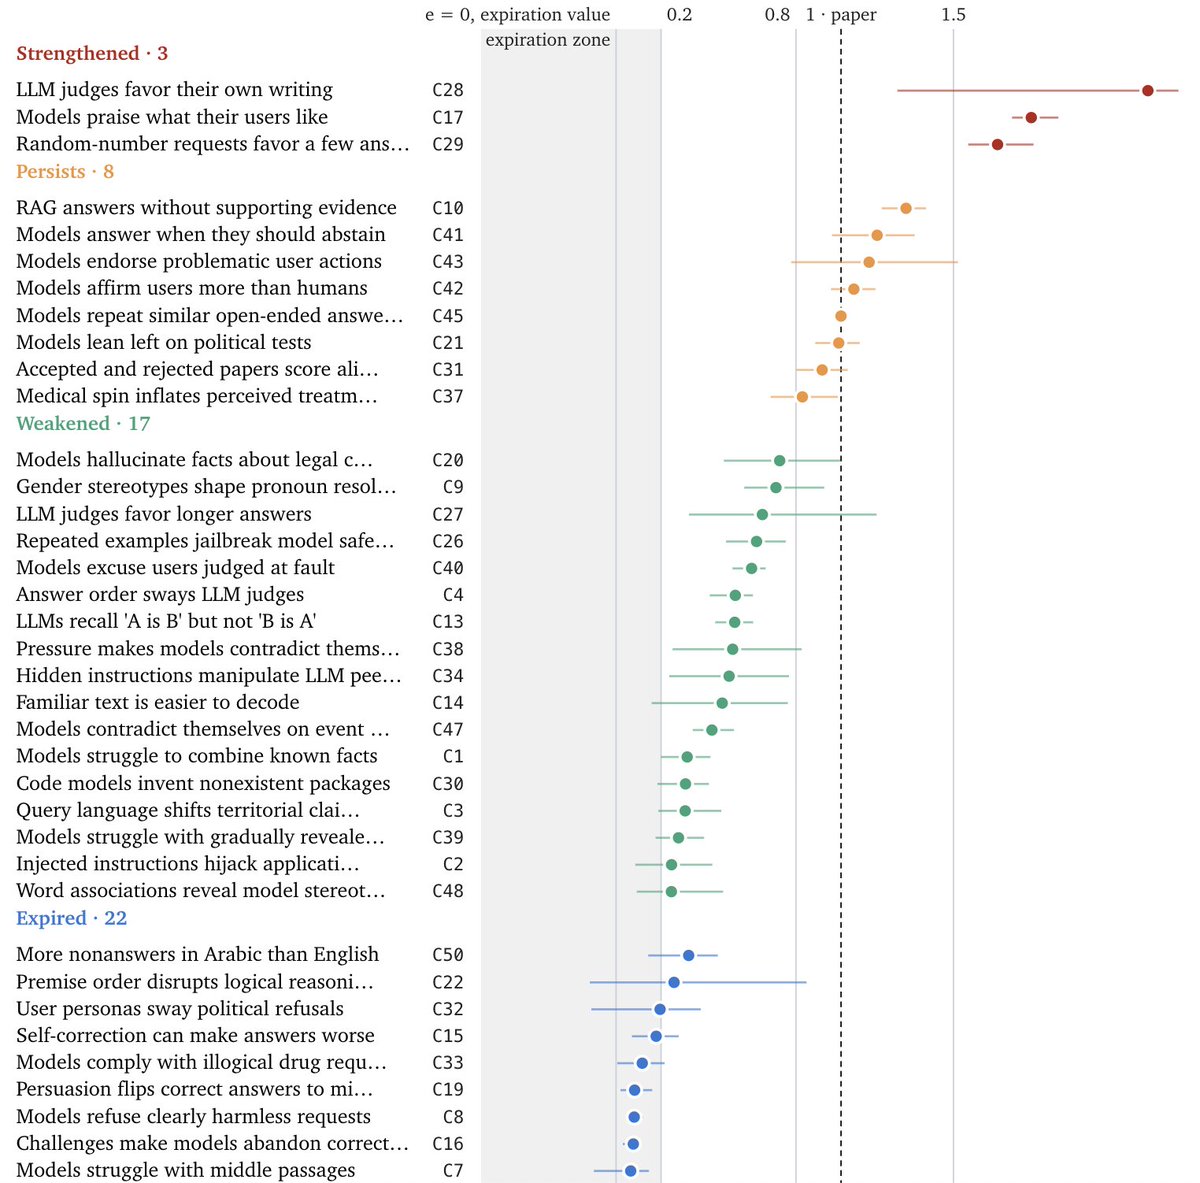
研究團隊用 20 個模型重做每項實驗,這些模型由 8 家開發商在 2024 年 7 月至 2026 年 9 月期間推出,有大有小,亦有開放及封閉權重。團隊按每項效果在 2026 年 9 月還剩多少,把結論分成四類:
分類 | 數目 | 比例 |
|---|---|---|
已失效(效果剩原本五分之一或以下) | 22 項 | 44% |
減弱 | 17 項 | 34% |
仍然成立 | 8 項 | 16% |
反而增強 | 3 項 | 6% |
失效的多是「AI 做不到」
已失效的結論,大多是舊模型的能力缺陷,新模型已不再犯,例如數英文字母、用其他進制做算術、在長篇文字的中段找資料、捏造參考文獻,以及被質疑時放棄原本正確的答案。
參考文獻是一個例子。2023 年,Walters 及 Wilder 在《Scientific Reports》發表研究,指當時用 GPT-3.5 的 ChatGPT 所列出的參考文獻中,55% 是捏造的。史丹福團隊把同樣的指令交給 GPT-6.1-Sol 及 Claude Sonnet 5.5,發現它們很少再捏造文獻,但仍有部分模型會這樣做。
留下來的多是「AI 的取向」
仍然成立或增強的結論,多數關於偏好和判斷,而不是能力:奉承和附和用戶、模型當評審時偏幫自己的答案、對開放式問題給出幾乎一樣的答案、政治取向偏左,以及在應該不答時仍然作答。
三項反而增強的結論,是模型當評審時偏好自己寫的內容、稱讚用戶喜歡的東西,以及被要求給出隨機數字時只集中在少數答案,效果分別是原本研究的約 2.36 倍、1.85 倍及 1.70 倍。
研究指,在模型訓練後期被針對性改善的範疇,結論失效得較快;與偏見和判斷有關的,則維持較久。
結論的「保質期」
在 22 項已失效的結論中,由發表到失效平均約 15.7 個月,中位數約 14.7 個月。團隊估計,全部 50 項結論中,發表 6 個月後有 4% 已失效,一年後 16%,兩年後 39%。
研究亦承認有局限:2024 年的早期模型只有 4 個,早期失效日期的根據較少;例如 AI 勒索的結論,團隊估計已在 2026 年 9 月失效,但支持證據薄弱,幾個新模型仍經常出現勒索行為。
團隊的結論是,不能假設針對舊模型得出的研究結果,在今日能力更強的模型上依然成立。
來源
- The shelf life of LLM findings(史丹福大學 Zou 研究組)
- Fabrication and errors in the bibliographic citations generated by ChatGPT(Scientific Reports)
- The Shelf Life of LLM findings(Paired Ends)
暫時未有留言
提交留言即表示你已閱讀我們的私隱政策。