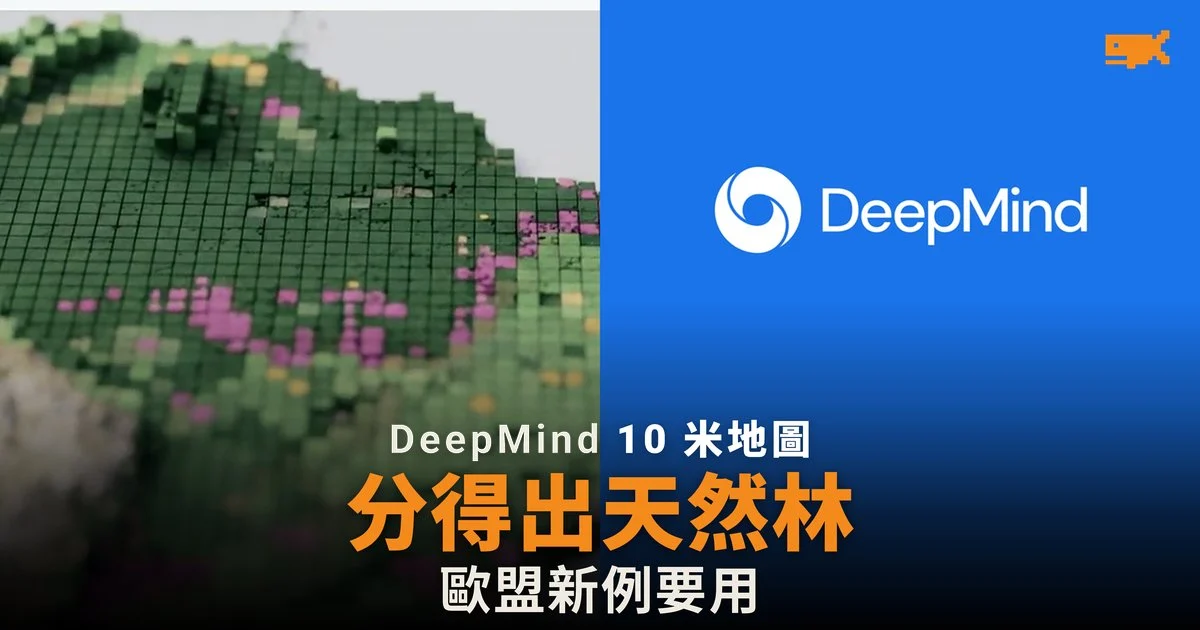
Google DeepMind 10 月 22 日公開 ForTy:10 米解像度的全球森林分類地圖
據 Google DeepMind 2026 年 10 月 22 日的公告,Google DeepMind 與 Google Research,聯同世界資源研究所(WRI)及國際應用系統分析研究所(IIASA),發布 Forest Typology(ForTy)2020 地圖,把地球上每一塊 10 米乘 10 米的土地,分成六類森林或土地用途。同時發布的還有一套早期時間序列,逐年追蹤 2017 年至 2025 年的變化,包括天然林在哪裡被換成人工林或農地。
項目 | 內容 |
|---|---|
公布日期 | 2026 年 10 月 22 日 |
名稱 | Forest Typology(ForTy)2020 v1 |
解像度 | 10 米 |
覆蓋範圍 | 南緯 65 度至北緯 84 度之間所有陸地 |
基準年 | 2020 年 |
時間序列 | 2017 年至 2025 年,逐年 |
合作方 | Google Research、WRI、IIASA |
取用 | Google Earth Engine,開放授權免費 |
六個分類按聯合國糧農組織定義,人工林與種植林以 40 年輪伐期劃界
據 Google Earth Engine 資料目錄的 ForTy v1 說明,六個類別分別是原始林(原生樹種、無可見人為干擾痕跡)、自然更新林(以自然更新為主,包括受干擾後恢復的次生林)、人工林(以種植或播種建立,輪伐期超過 40 年)、種植林(集約管理、一至兩個樹種、樹齡一致,輪伐期 40 年或以下)、樹木作物及農林業(油棕、橡膠、果園等非木材用途),以及其他土地。
Google DeepMind 在公告中表示,問題在於「從太空看,一片原始雨林、一個桉樹種植場同一個油棕園,可以是同一片綠色」,但三者的碳儲量與生物多樣性差別極大。該公司去年已與同一批夥伴發布 Natural Forests of the World 2020,當時只回答一條問題:某幅土地在 2020 年是否天然林。ForTy 進一步指出那是哪一種森林。
這張圖的用處先在歐盟法規:2020 年 12 月 31 日是零毀林的基準日
據刊於《Scientific Data》第 13 卷第 1434 號的論文,歐盟《零毀林產品條例》(EUDR)以 2020 年 12 月 31 日為基準日,要求進入歐盟市場的商品既不涉及毀林,亦不涉及森林退化。Google DeepMind 的公告指,咖啡、可可、棕櫚油等產品不得來自 2020 年屬森林、其後被改作農業用途的土地;木製品例如傢俬,亦不得來自其後被改成種植林或人工林的原始林。
論文補充,EUDR 把「毀林」(森林改作農業用途)與「森林退化」(森林用途之內的結構改變,例如原始林變成種植林)分開處理,而要監察這兩種過程,就需要一個記錄基準日當刻森林類型的靜態底圖,而不是單看有沒有樹。論文同時指出,按每公頃現存熱帶森林付款的熱帶森林永續基金(TFFF),同樣需要把種植林與樹木作物剔出合資格森林面積。
訓練用了 170 萬個標註地點,驗證在 8,190 個隨機樣點做
據《Scientific Data》論文,ForTy 用一條串連式深度學習流程,以 170 萬個全球分布的樣本訓練,從衛星影像嵌入(embeddings,把多年衛星觀測壓縮成每個像素一組數值的摘要)生成各類別的相對信心圖,方法結合弱監督學習與主動學習。Google DeepMind 的公告指,模型的關鍵輸入是 AlphaEarth Foundations 嵌入,因此可以看出種植圖案、生長周期與收割節奏等細微線索。
指標 | 數字 | 出處 |
|---|---|---|
訓練樣本 | 170 萬個全球分布標註地點 | 《Scientific Data》論文 |
驗證樣點 | 8,190 個專家標註的分層隨機樣點 | 《Scientific Data》論文 |
六類整體準確率 | 90.2% | 《Scientific Data》論文 |
天然林分類準確率 | 94.8% | 《Scientific Data》論文 |
森林/非森林準確率 | 95.5% | 《Scientific Data》論文 |
全球森林佔陸地面積 | 約 31% | 《Scientific Data》論文引述 |
全球森林碳儲量 | 約 6,620 億噸 | 《Scientific Data》論文引述 |
Google DeepMind 的公告指,驗證由 IIASA 與 WRI 共同進行,每個樣點由兩名受訓專家查看高解像度影像及多年衛星紀錄,判斷實際屬於哪一類;結果 ForTy 「表現優於其他全球森林地圖」。
輸出的不是標籤而是機率,使用者自行決定門檻
據 Earth Engine 資料目錄,ForTy 的主要資料是一個五波段的 8 位元整數柵格,數值 0 至 250 代表五個森林類別的量化機率,第六類「其他土地」的機率由 250 減去前五項之和得出;把每個像素分配給機率最高的類別,就可以還原成一張分類圖。
Google DeepMind 解釋這個設計的用意:在 EUDR 之下評估毀林風險的公司,可以把門檻設得很嚴,只接受模型極有把握的像素以避開監管風險;而估算森林總面積的研究人員,則可以用整個機率區間。公告又指,當天然林被砍伐後改種成種植林,土地很快又變回綠色,一般的樹冠覆蓋地圖未必察覺到這種變化,而時間序列正是要令這類「隱形」的改變顯示出來。
來源
- Beyond tree cover: mapping the world's forest types(Google DeepMind 公告)
- Global forest typology at 10-meter resolution for forest and land-use monitoring(Scientific Data 論文)
- Forest Typology (ForTy) 2020 v1.0(Earth Engine 資料目錄,資料規格)
暫時未有留言
提交留言即表示你已閱讀我們的私隱政策。